Categoria: Social Media

In questa categoria trovate articoli che riportano dati e ricerche sul mondo dei Social Media. Dal numero di utenti connessi, al tempo trascorso su ciascun social network

  • Mark Zuckerberg e la tassa che scuote le Big Tech in California

    Mark Zuckerberg e la tassa che scuote le Big Tech in California

    La proposta di una tassa sui grandi patrimoni in California spinge Zuckerberg a valutare il trasferimento. Meta interviene con un accordo che tutela il suo controllo sull’azienda e apre nuove questioni sul potere delle Big Tech.

    In un momento storico in cui si parla molto di big tech, potere della IA e di “oligarchi digitali”, la vicenda che riguarda Mark Zuckerberg assume un significato molto particolare. In questa occasione cerchiamo di spiegare come sono andate le cose e soprattutto cosa c’entrano le big tech e le elezioni dei medio termine negli Usa, perché l’appuntamento elettorale del 3 novembre prossimo tocca anche altri temi.

    Allora, lo stato della California vuole chiedere ai miliardari un contributo straordinario sui loro patrimoni. Mark Zuckerberg, uno degli uomini più ricchi del mondo, co-fondatore e CEO di Meta, aveva preparato il trasferimento della propria residenza fuori dallo Stato. Aveva persino comunicato ai consiglieri di Meta una data precisa per mettere in vendita la sua casa di Palo Alto.

    Sulla questio è intervenuta Meta e, dopo settimane di trattative, i dirigenti dell’azienda hanno raggiunto con lui un accordo con Zuckerberg che gli permette di dotarsi del denaro necessario per affrontare l’eventuale tassa senza ridurre il proprio potere di voto nell’azienda.

    In cambio, Zuckerberg si è impegnato a restare in California per otto anni, salvo particolari circostanze previste dall’accordo.

    Non ci troviamo nella sfera delle indiscrezioni. Infatti, la storia è raccontata nei documenti che Meta ha depositato il 21 ottobre 2026 presso la SEC, l’autorità americana che vigila sui mercati finanziari.

    E merita di essere raccontata perché si sviluppa in un momento in cui le grandi aziende tecnologiche investono decine di miliardi nell’intelligenza artificiale, concentrano risorse economiche sempre maggiori e vedono i loro fondatori esercitare un’influenza che va ben oltre la gestione delle rispettive imprese.

    La tassa del 5% che spaventa i miliardari della Silicon Valley

    Al centro della vicenda c’è la Proposition 40, una proposta sulla quale gli elettori della California saranno chiamati a votare il prossimo 3 novembre, nello stesso giorno delle elezioni americane di metà mandato.

    La misura prevede un’imposta straordinaria del 5% sui patrimoni superiori a un miliardo di dollari. Non sarebbe una tassa annuale sui redditi, ma un prelievo da applicare una sola volta, destinato principalmente a finanziare la sanità e a compensare parte delle riduzioni dei finanziamenti federali.

    Per comprendere le dimensioni della questione basta considerare il patrimonio di Zuckerberg. Secondo le stime più recenti la sua ricchezza supera i 220 miliardi di dollari. Un’imposta del 5% potrebbe quindi comportare un pagamento superiore agli 11 miliardi di dollari. Una cifra considerevole, anche per chi dispone di un patrimonio di quelle dimensioni.

    Ma cerchiamo di capire perché la questione sia diventata così importante per Meta. La ricchezza di Zuckerberg non è costituita prevalentemente da denaro depositato in banca, ma è legata soprattutto alle azioni dell’azienda che ha fondato. Per pagare una tassa di diversi miliardi potrebbe quindi dover vendere una parte di quelle azioni oppure ottenere un prestito offrendo i titoli come garanzia.

    E vendere azioni Meta, per Zuckerberg, non significa soltanto ridurre il proprio patrimonio, significa anche mettere a rischio il controllo che esercita sulla società.

    Va chiarito, però, un aspetto importante della proposta californiana. Secondo il testo esaminato dall’ufficio legislativo dello Stato, la tassa riguarderebbe chi risultava residente in California il 1° gennaio 2026, anche se nel frattempo avesse cambiato residenza. Il pagamento sarebbe previsto nel 2027, con la possibilità di distribuirlo su più anni a condizioni meno favorevoli.

    Questo significa che un trasferimento effettuato a settembre non avrebbe automaticamente cancellato l’eventuale obbligo fiscale. La volontà di Zuckerberg di lasciare la California è documentata, ma non si può dire che quella scelta gli avrebbe consentito di evitare il pagamento.
    Mark Zuckerberg e la tassa che scuote le Big Tech in California

    Zuckerberg aveva già preparato la partenza

    La vicenda comincia a prendere forma durante l’estate del 2026.

    Il 4 agosto Zuckerberg presenta agli amministratori di Meta una proposta per modificare la struttura delle azioni della società. Il tema della possibile tassa californiana è già entrato nelle discussioni interne all’azienda. Nelle settimane successive le trattative diventano più serrate.

    Il 6 settembre Zuckerberg spiega ai dirigenti Meta che, per trasferire la propria residenza fuori dalla California entro metà ottobre, avrebbe dovuto cominciare le procedure necessarie entro metà settembre. Non è una dichiarazione generica sulla possibilità di andarsene, ma è un programma con tempi precisi, comunicato direttamente ai consiglieri di Meta.

    Pochi giorni dopo, durante una riunione del consiglio di amministrazione del 9 settembre, arriva anche il riferimento alla sua abitazione di Palo Alto. Zuckerberg comunica che intende metterla in vendita il 13 settembre.

    La notizia, una volta resa pubblica, avrebbe inevitabilmente alimentato interrogativi anche all’interno di Meta. Perché il fondatore dell’azienda stava preparando il trasferimento? Avrebbe continuato a lavorare dalla California? E quali conseguenze avrebbe avuto la sua partenza sulla gestione della società?

    Sono questioni che emergono dalla documentazione ufficiale.

    Su un punto, però, bisogna essere precisi. Al 23 ottobre 2026 non risulta confermata la vendita effettiva della casa. I documenti attestano l’intenzione di metterla sul mercato, non la conclusione dell’operazione. Nel frattempo, Zuckerberg e la moglie Priscilla Chan avevano già acquistato una proprietà a Indian Creek, in Florida, per circa 170 milioni di dollari, come riportato da diverse fonti. Anche questo acquisto è documentato. Non costituisce però, da solo, la prova di un trasferimento della residenza fiscale.

    Il problema di Meta non era soltanto trattenere Zuckerberg in California

    A questo punto entra in gioco il consiglio di amministrazione di Meta. Per comprendere perché gli amministratori siano intervenuti bisogna spiegare un particolare.

    Zuckerberg possiede economicamente circa il 13,4% di Meta, ma controlla il 60,6% dei voti che determinano le decisioni dell’azienda. Come è possibile?

    Meta ha due categorie principali di azioni. Le azioni ordinarie di classe A attribuiscono un voto ciascuna. Quelle di classe B, possedute soprattutto da Zuckerberg, attribuiscono invece dieci voti ciascuna. Questo meccanismo permette al fondatore di controllare l’azienda anche senza possederne la maggioranza del capitale.

    Se avesse dovuto vendere una quantità consistente delle sue azioni per pagare la tassa, il suo potere di voto avrebbe potuto scendere dal 60,6% a circa il 53%. Avrebbe mantenuto la maggioranza, dunque, ma con un margine inferiore.

    Gli amministratori di Meta non erano quindi davanti al rischio immediato di perdere il controllo esercitato da Zuckerberg. La questione riguardava piuttosto la possibilità che quel controllo si riducesse nel tempo, anche in conseguenza di nuove operazioni finanziarie.

    E c’era un’altra preoccupazione.

    Meta sta destinando risorse enormi allo sviluppo dell’intelligenza artificiale, dalle infrastrutture informatiche ai sistemi più avanzati. Gli amministratori ritenevano importante che Zuckerberg continuasse a dirigere personalmente queste attività, rimanendo vicino alla sede centrale di Menlo Park e ai gruppi di lavoro impegnati nella ricerca.

    Nel documento presentato alla SEC viene richiamata anche l’esperienza della pandemia, quando la distanza fisica del fondatore aveva creato difficoltà nella gestione dell’azienda.

    In buona sostanza, Meta voleva evitare che Zuckerberg lasciasse la California e, contemporaneamente, preservare la struttura di controllo sulla quale si regge la società.

    Per farlo, però, serviva un accordo.

    Le trattative e la soluzione

    Le discussioni non sono state facili. Meta aveva costituito un gruppo di amministratori indipendenti, affiancati da consulenti finanziari e legali, con il compito di valutare le proposte di Zuckerberg e tutelare anche gli interessi degli altri azionisti.

    Durante agosto e settembre vengono esaminate diverse possibilità. Zuckerberg propone inizialmente una distribuzione molto ampia di nuove azioni. Gli amministratori chiedono modifiche, garanzie e soprattutto impegni precisi sulla sua permanenza alla guida dell’azienda.

    Il confronto prosegue fino al 14 settembre, quando viene raggiunta un’intesa sui termini principali. La soluzione consiste nella creazione di una nuova categoria di azioni Meta, denominata classe C. Sono azioni che hanno un valore economico, possono essere acquistate e vendute, ma non attribuiscono alcun diritto di voto.

    Per ogni azione già posseduta, gli azionisti di Meta riceveranno una nuova azione di classe C. Zuckerberg, quindi, riceverà queste nuove azioni come tutti gli altri soci. La differenza è che potrà venderne una parte senza dover cedere quelle che gli garantiscono il controllo dell’azienda. Il meccanismo è più semplice di quanto possa sembrare.

    Se Zuckerberg vende un’azione che attribuisce dieci voti, perde anche quei dieci voti. Se invece vende una nuova azione che non attribuisce alcun voto, ottiene denaro ma conserva il potere decisionale legato alle azioni che continua a possedere. È questo il principio sul quale si basa l’accordo.

    Zuckerberg potrà vendere liberamente il 20% delle nuove azioni ricevute. Sul restante 80% sono previste limitazioni che verranno eliminate gradualmente, a condizione che continui a svolgere le funzioni concordate. Ogni tre mesi potrà vendere senza quelle limitazioni un ulteriore 2,5% delle nuove azioni.

    Il periodo complessivo è di otto anni.

    Non significa che Meta pagherà direttamente la sua eventuale tassa. Il denaro arriverà dalla vendita di azioni appartenenti a Zuckerberg, non da un pagamento della società al fisco per conto suo. Ma significa che Meta ha modificato la propria struttura azionaria anche per consentire al fondatore di affrontare un possibile esborso miliardario senza ridurre il suo potere di voto.

    E questa è una delle questioni centrali dell’intera vicenda.

    Zuckerberg e gli otto anni in California

    L’accordo prevede anche obblighi precisi per Zuckerberg.

    Il fondatore si è impegnato a continuare a lavorare a tempo pieno nella direzione di Meta, oppure come presidente esecutivo del consiglio di amministrazione, secondo le condizioni stabilite. Ha inoltre accettato di mantenere la residenza in California, oppure nello Stato in cui Meta dovesse trasferire la propria sede centrale, per otto anni.

    Sono previste eccezioni in presenza di circostanze straordinarie e impreviste.

    Il consiglio di amministrazione ha approvato l’operazione il 19 ottobre. Il giorno successivo è arrivata l’approvazione degli azionisti che disponevano della maggioranza dei voti.

    Il 21 ottobre Meta ha reso pubblica la documentazione e le nuove azioni saranno introdotte il 19 gennaio 2027.

    L’operazione, inoltre, non riguarda soltanto le esigenze personali di Zuckerberg. Meta potrà utilizzare questa nuova categoria di azioni anche per raccogliere capitali, finanziare acquisizioni e remunerare i dipendenti, senza modificare i rapporti di voto tra gli azionisti.

    Si tratta di un vantaggio che la società ha indicato esplicitamente nella documentazione ufficiale. Resta il fatto che l’intera trattativa ha avuto tra le sue ragioni principali la possibile imposta californiana e la volontà di evitare che Zuckerberg lasciasse lo Stato.

    Il potere delle Big Tech e il contesto delle elezioni americane

    Questa storia si sviluppa in un momento particolare per gli Stati Uniti.

    Mancano pochi giorni alle elezioni di metà mandato del 3 novembre, mentre il rapporto tra potere economico, grandi aziende tecnologiche e politica è diventato uno degli elementi più rilevanti del dibattito pubblico americano. Basta osservare quanto sta accadendo in Texas.

    Elon Musk sta finanziando con somme enormi le iniziative a sostegno del candidato repubblicano al Senato Ken Paxton, impegnato contro il democratico James Talarico.

    Secondo una ricostruzione pubblicata da Reuters il 21 ottobre 2026, Musk ha destinato 158 milioni di dollari al sostegno di Paxton, mentre altri grandi finanziatori repubblicani partecipano a una campagna elettorale che sta mobilitando centinaia di milioni di dollari.

    Musk è intervenuto anche personalmente contro Talarico, attraverso dichiarazioni pubbliche e attacchi diffusi sulla sua piattaforma X. Sono vicende diverse, che non vanno sovrapposte. Non esistono elementi per sostenere che la trattativa tra Zuckerberg e Meta sia collegata alle iniziative elettorali di Musk.

    Ma entrambe appartengono allo stesso contesto, nel quale i grandi patrimoni accumulati attraverso le aziende tecnologiche assumono un peso crescente anche al di fuori dell’attività industriale.

    Da una parte c’è un imprenditore che investe somme ingenti per sostenere candidati politici. Dall’altra c’è il fondatore di una delle maggiori piattaforme digitali del mondo che valuta di lasciare uno Stato americano per una possibile imposta sul patrimonio, mentre la sua azienda interviene per trovare una soluzione.

    In entrambi i casi, il rapporto tra ricchezza privata e decisioni pubbliche diventa una questione che riguarda tutti, anche la politica.

    La California, i miliardari e una questione ancora aperta

    La proposta della California ha provocato reazioni contrastanti anche all’interno dello stesso Partito Democratico.

    Il governatore della California, il democratico Gavin Newsom, si è dichiarato contrario alla tassa, sostenendo che potrebbe spingere i contribuenti più ricchi a lasciare lo Stato, con conseguenze sulle entrate fiscali.

    I promotori della misura, sostenuta dal sindacato SEIU United Healthcare Workers West, ritengono invece che un contributo straordinario dei patrimoni miliardari possa aiutare a finanziare servizi pubblici essenziali, soprattutto la sanità. La vicenda Zuckerberg è diventata così anche un argomento del confronto politico.

    I sostenitori della tassa hanno interpretato l’accordo raggiunto con Meta come una dimostrazione del fatto che i grandi patrimoni non siano necessariamente destinati a lasciare la California.

    Gli oppositori continuano invece a contestare le conseguenze economiche che la misura potrebbe avere.

    Gli elettori si pronunceranno il 3 novembre. E non risulta neppure confermato che Zuckerberg abbia completato il trasferimento di residenza o venduto la propria abitazione di Palo Alto. L’accordo con Meta, invece, è già stato approvato e documentato. Ed è questo il fatto che rende la vicenda particolarmente significativa.

    La vicenda non dimostra che la tassa californiana sia giusta o sbagliata. E non dimostra neppure che Zuckerberg avrebbe potuto evitarla semplicemente cambiando residenza.

    Documenta però quanto una decisione pubblica che riguarda la tassazione dei grandi patrimoni possa arrivare a incidere sulle scelte di un’azienda privata delle dimensioni di Meta.

    E ci riporta a una questione che accompagnerà sempre di più il confronto sull’economia digitale: quale rapporto può esistere tra la concentrazione di ricchezza nelle grandi aziende tecnologiche, il potere dei loro fondatori e la capacità delle istituzioni democratiche di intervenire attraverso le proprie decisioni?
  • Meta, i ricavi dalla pubblicità pagano gli investimenti in IA

    Meta, i ricavi dalla pubblicità pagano gli investimenti in IA

    Meta cresce con la pubblicità e investe di più nell’IA. Threads aumenta il tempo trascorso, WhatsApp segna un record di messaggi. Muse supera 10 milioni di configurazioni, ma Meta non comunica ricavi, costi e perdite.

    Il conto dell’intelligenza artificiale di Meta passa ancora dai social. Facebook, Instagram, Threads e WhatsApp sostengono quasi tutto il fatturato del gruppo e, attraverso la pubblicità, finanziano l’infrastruttura necessaria per addestrare e distribuire nuovi modelli. Nel terzo trimestre 2026 questa relazione diventa più evidente: il motore pubblicitario continua a crescere, mentre gli investimenti superano il flusso di cassa generato dalle attività operative.

    La trascrizione ufficiale della conference call definisce Muse come un agente personale, appena lanciato negli Stati Uniti e in Canada, e attribuisce al prodotto i primi dati di adozione della IA di casa Menlo Park. Il documento non contiene però un conto economico separato, quindi Meta non comunica quanto Muse abbia incassato, quanto costi nel complesso o quale perdita produca.

    I ricavi di Meta in crescita e il free cash flow negativo

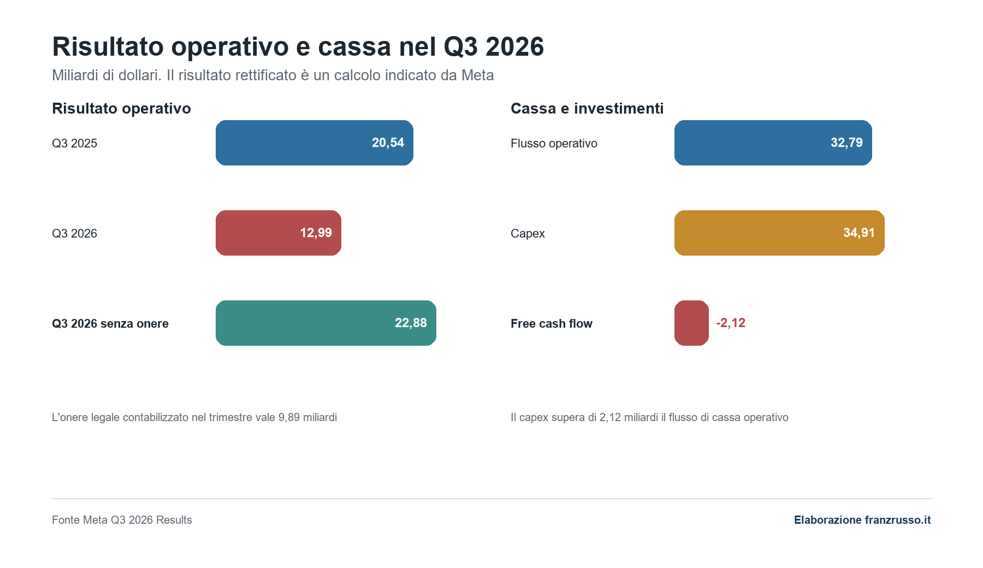
    Secondo il comunicato sui risultati, Meta ha chiuso il terzo trimestre del 2026 con 64,60 miliardi di dollari di ricavi, il 26% in più rispetto ai 51,24 miliardi dello stesso periodo del 2025. I costi e le spese sono saliti a 51,61 miliardi, con una crescita del 68%. Il reddito operativo si è così ridotto da 20,54 a 12,99 miliardi e il margine operativo è sceso dal 40% al 20%.

    Questa contrazione non descrive da sola l’andamento industriale. Nei costi del trimestre è compreso un onere da 9,89 miliardi legato all’accordo con 52 procuratori generali statunitensi sulle controversie riguardanti salute mentale degli adolescenti e social media. I pagamenti previsti dall’accordo possono arrivare a circa 18,59 miliardi.

    Meta, i ricavi dalla pubblicità pagano gli investimenti in IA
    Meta, i ricavi dalla pubblicità pagano gli investimenti in IA

    Escludendo l’onere contabilizzato nel trimestre, Meta indica un reddito operativo di 22,88 miliardi, in aumento dell’11% su base annua, e un margine vicino al 35% secondo il rapporto tra quel risultato e i ricavi. Il costo deriva dalle controversie sulle piattaforme, non dagli investimenti nell’IA. Il comunicato segnala inoltre altri processi negli Stati Uniti su questioni riguardanti i giovani nei prossimi mesi.

    Anche il confronto sull’utile netto richiede cautela. I 9,86 miliardi del Q3 2026 risultano superiori del 264% ai 2,71 miliardi di un anno prima, ma il Q3 2025 era stato penalizzato da un onere fiscale non monetario una tantum di 15,93 miliardi. L’aumento percentuale nei termini è corretto; non misura però un’accelerazione equivalente del risultato industriale.

    La misura più utile per capire la pressione degli investimenti è il flusso di cassa. Gli esborsi in conto capitale, inclusi i pagamenti principali dei leasing finanziari, sono arrivati a 34,91 miliardi nel trimestre, contro 19,37 miliardi un anno prima. Il flusso di cassa operativo è salito da 30,00 a 32,79 miliardi, ma non è bastato a coprire gli investimenti. Il free cash flow, cioè la cassa che resta dopo quegli esborsi, è passato da 10,63 miliardi positivi a 2,12 miliardi negativi. Nei dati presentati agli investitori il passaggio appare con particolare chiarezza: i ricavi continuano a salire, ma gli investimenti crescono più rapidamente.

    Dati Meta Q3 2026 risultato operativo
    Dati Meta Q3 2026 risultato operativo

    Meta prevede ora per l’intero 2026 investimenti tra 135 e 145 miliardi di dollari, restringendo il precedente intervallo di 130-145 miliardi. Non è corretto definire l’intera cifra come spesa per l’IA, perché l’azienda la riferisce a server, data center e infrastruttura di rete destinati anche alle attività esistenti.

    La stessa società collega però l’espansione della capacità alla formazione dei modelli, alla crescita delle piattaforme e allo sviluppo dei nuovi prodotti di IA. L’impegno finanziario è documentato, mentre una perdita complessiva del settore IA non viene pubblicata come voce autonoma.

    La pressione si vede anche nella ricerca e sviluppo, salita da 15,14 a 20,05 miliardi di dollari nel trimestre, il 32% in più. La voce comprende attività diverse e non può essere attribuita interamente all’intelligenza artificiale, ma misura l’ampliamento della struttura di costo nella fase in cui Meta accelera sui nuovi modelli. Nello stesso tempo i dipendenti sono scesi a 66.775, il 15% in meno rispetto a un anno prima. Il comunicato non specifica quali funzioni abbiano subito la riduzione, perciò il dato segnala una riallocazione delle risorse senza consentire di attribuirla a Muse o a una singola area.

    In questo quadro rientra anche la nuova Classe C di azioni senza diritto di voto, approvata dal consiglio di amministrazione e destinata a diventare efficace il 19 gennaio 2027. Meta indica fra le motivazioni la possibilità di raccogliere capitale, finanziare la crescita, compensare i dipendenti e realizzare acquisizioni in una fase in cui la trasformazione legata all’IA richiede investimenti rilevanti. La struttura tutela anche la continuità del controllo di Mark Zuckerberg. Non significa che sia già stata annunciata un’emissione destinata all’IA, ma amplia gli strumenti finanziari disponibili senza modificare il potere di voto degli azionisti esistenti.

    La app di Meta generano il 99% dei ricavi

    La Family of Apps, che comprende Facebook, Instagram, Messenger, WhatsApp e gli altri servizi, ha generato 64,16 miliardi di dollari di ricavi, pari al 99,3% del totale del gruppo. Di questi, 63,06 miliardi provengono dalla pubblicità: il 97,6% dei ricavi complessivi di Meta. Gli altri ricavi sono stati 1,10 miliardi, il 59% in più su base annua, soprattutto grazie alla messaggistica a pagamento di WhatsApp e agli abbonamenti. Reality Labs ha aggiunto 443 milioni di ricavi, portando il totale a 64,60 miliardi.

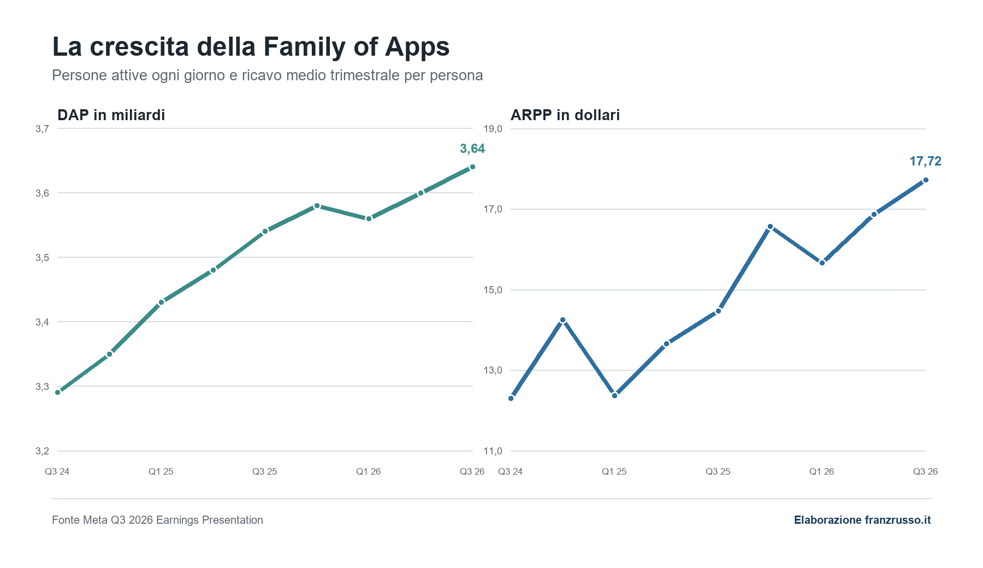
    Il rapporto tra scala e monetizzazione continua a migliorare. Le persone attive ogni giorno nella app di Meta hanno raggiunto 3,64 miliardi a settembre, con una crescita del 3% in un anno. Nello stesso periodo le impression pubblicitarie sono aumentate del 10% e il prezzo medio per inserzione del 14%.

    Nel trimestre il prezzo ha quindi contribuito alla crescita più del volume, senza rendere secondario l’aumento delle impression. Il ricavo medio trimestrale per persona è salito a 17,72 dollari. La base degli utenti cresce con un ritmo contenuto, mentre il valore prodotto da ciascuna relazione cresce più rapidamente.

    Meta non pubblica ricavi separati per Facebook, Instagram, Threads e WhatsApp. Per questa ragione non è possibile attribuire a una singola piattaforma una quota del fatturato pubblicitario.

    Facebook Instagram Threads e WhatsApp crescono in modi diversi

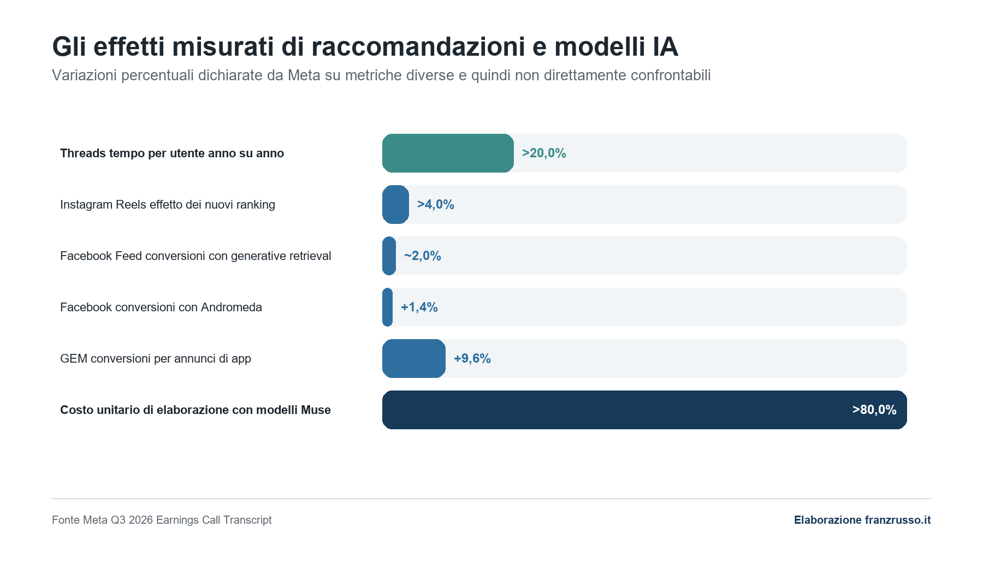
    Su Instagram il tempo trascorso per persona ha raggiunto un nuovo massimo ed è cresciuto a doppia cifra su base annua, sia nei Reels sia nel Feed. Gli aggiornamenti alla rilevanza introdotti nel trimestre hanno aumentato di oltre il 4% il tempo trascorso sui Reels. Il sistema ora valuta sequenze di contenuti invece di considerare ogni video isolatamente e utilizza segnali più ricchi sul tempo di visione.

    Quasi il 45% dei Reels raccomandati ha meno di un giorno, oltre 11 punti percentuali in più rispetto al trimestre precedente. I sistemi basati su modelli linguistici impiegati per comprendere i contenuti hanno inoltre aumentato dell’1% l’interazione con i risultati di ricerca di Instagram.

    Facebook mostra una dinamica simile. Il tempo trascorso sui Reels ha raggiunto nuovi massimi sia a livello globale sia negli Stati Uniti, con una crescita a doppia cifra. Meta ha completato il lancio globale di un’architettura di recupero generativo che assegna rappresentazioni semantiche ai contenuti e può proporre post pertinenti prima che abbiano accumulato molte interazioni. Il sistema copre circa un quarto delle visualizzazioni del Feed provenienti da account non seguiti e metà delle visualizzazioni dei Reels, con un aumento dell’1% del tempo di visione dei Reels. Negli Stati Uniti, l’estensione della cronologia considerata dal modello di ranking ha prodotto un ulteriore incremento dell’1%.

    Per Threads, Zuckerberg ha affermato che la piattaforma ha superato X negli utenti attivi mensili, senza comunicare nella call un nuovo valore assoluto. La metrica verificabile resa pubblica per il trimestre è un aumento superiore al 20% del tempo trascorso per persona su base annua. È un’indicazione di crescita dell’uso, non una misura diretta dei ricavi. Meta non ha indicato quanto Threads abbia monetizzato nel trimestre.

    WhatsApp ha registrato, secondo la società, un massimo storico nei messaggi e sta assumendo un ruolo crescente come piattaforma per gli agenti. La crescita del 59% degli altri ricavi della app è stata trainata soprattutto dalla messaggistica a pagamento di WhatsApp e dagli abbonamenti, ma Meta non separa le due componenti. Anche il dato di 15 milioni riguarda insieme abbonamenti e prove di Meta One, il servizio distribuito su Instagram, Facebook e WhatsApp. Non equivale quindi a 15 milioni di abbonati paganti.

    I sistemi di raccomandazione sono già una voce economica

    L’intelligenza artificiale produce già risultati misurabili nel business pubblicitario. Il Meta Generative Recommender, applicato al recupero degli annunci nel Feed di Facebook, ha aumentato di quasi il 2% le conversioni nei segmenti coinvolti. L’estensione del modello GEM ha generato un aumento dell’1,7% nelle conversioni delle campagne dirette fuori dalle piattaforme e del 9,6% nelle conversioni degli annunci per app.

    Sono percentuali riferite a sistemi e perimetri diversi, perciò non vanno sommate. Insieme, però, spiegano perché Meta sostenga che gli investimenti in IA stiano producendo ricavi pubblicitari incrementali: migliorano la selezione dei contenuti, aumentano il tempo trascorso nelle app e rendono più efficace l’abbinamento tra annunci e persone. È lo stesso circuito economico che ha sostenuto la crescita del 26% dei ricavi pubblicitari della app della famiglia Meta

    Nel trimestre Meta ha iniziato a trasferire i sistemi di comprensione dei contenuti sulla famiglia di modelli proprietari Muse. Nelle valutazioni interne, questi modelli avrebbero superato quelli precedenti e ridotto di oltre l’80% il costo unitario di elaborazione su Instagram, Threads, Facebook e nei sistemi pubblicitari. La formulazione è importante: si tratta di una riduzione del costo per unità nelle valutazioni dell’azienda, non di una riduzione dell’80% dei costi complessivi delle piattaforme.

    Muse esiste davvero ma il conto economico non è ancora visibile

    Muse è effettivamente il prodotto annunciato da Meta. Nel comunicato di lancio dell’8 settembre l’azienda lo presenta come un agente personale capace di agire per conto dell’utente, continuare a lavorare quando l’app è chiusa e collegarsi ai servizi utilizzati ogni giorno. Funziona in un ambiente virtuale dedicato, Muse Secure VM, ed è disponibile negli Stati Uniti e in Canada. La call di ieri, 21 ottobre 2026, aggiunge i primi dati: oltre 10 milioni di persone lo hanno configurato in circa sei settimane e circa il 25% di chi lo ha configurato lo utilizza in un giorno medio.

    L’uso più frequente è lo shopping. Più di un quarto degli utenti attivi settimanali lo utilizza per acquistare e Meta indica un valore medio dell’acquisto superiore a 200 dollari. Questo dato misura il valore delle transazioni facilitate, non i ricavi di Muse. Gli altri impieghi più comuni riguardano produttività personale e creatività. La versione Muse for Small Business collega l’agente agli account professionali di Instagram, alle Pagine Facebook, agli account pubblicitari e a servizi esterni. La platea potenziale indicata dalla società è di almeno 500 milioni di piccole imprese autoidentificate che usano le app di Meta, ma si tratta di una stima della base raggiungibile, non di utenti attivi di Muse.

    La monetizzazione è ancora un progetto in costruzione. Meta indica abbonamenti per i modelli più avanzati e per un maggiore utilizzo, commissioni sulle transazioni facilitate, servizi a pagamento per le imprese, API e Muse Code. Muse Wonder è già accessibile nel livello a pagamento, mentre Muse Spark resta il modello predefinito per il livello gratuito. Nessuno dei documenti trimestrali comunica ricavi specifici per queste linee.

    Anche le perdite non sono divulgate. Meta presenta soltanto due segmenti, Family of Apps e Reality Labs, e non fornisce una riga separata per Muse o per Meta Superintelligence Labs. La CFO Susan Li ha dichiarato che l’espansione della base utenti farà aumentare i costi complessivi di servizio, perché Muse richiede molta capacità di calcolo. La società prevede di migliorare l’efficienza del calcolo di oltre dieci volte nel prossimo anno attraverso un uso migliore della capacità nelle ore meno richieste, modelli più efficienti e ottimizzazione dell’inferenza. È una previsione aziendale. Non consente di calcolare né la perdita attuale né il momento in cui il prodotto raggiungerà il pareggio.

    La scala immaginata è molto più ampia dei numeri attuali. Zuckerberg ha parlato della capacità necessaria per servire oltre un miliardo di persone, a condizione di raggiungere gli obiettivi di efficienza. I dieci milioni di configurazioni e il tasso di utilizzo quotidiano costituiscono un segnale iniziale, non la prova che l’adozione sia già consolidata. L’espansione globale dipende dalla possibilità di ridurre il costo di ogni interazione prima che la distribuzione moltiplichi la spesa.

    Reality Labs riduce le perdite mentre cambia funzione

    Reality Labs ha registrato 443 milioni di dollari di ricavi nel trimestre, il 6% in meno rispetto a un anno prima. La flessione delle vendite dei visori Quest è stata compensata solo in parte dalla crescita degli occhiali con IA. La perdita operativa è stata di 4,13 miliardi, inferiore ai 4,43 miliardi del Q3 2025 ma ancora quasi dieci volte superiore ai ricavi del segmento.

    Meta prevede per Reality Labs perdite tra 18 e 19 miliardi nel 2026 e circa 15 miliardi nel 2027. La riduzione attesa deriva anche dalla riallocazione degli investimenti verso l’IA. Nello stesso tempo, Muse dovrebbe arrivare sui Meta Glasses e diventare parte del loro modello economico attraverso gli abbonamenti. Reality Labs non scompare dalla strategia: cambia priorità, con meno enfasi sul ritmo di nuovi dispositivi per la realtà virtuale e più attenzione agli occhiali come punto di accesso all’agente personale.

    La sostenibilità economica di Muse resta da dimostrare

    Per il quarto trimestre Meta prevede ricavi compresi tra 73 e 76 miliardi di dollari, con un effetto negativo dei cambi vicino all’1% sulla crescita annua. Le spese complessive del 2026 sono stimate tra 175 e 179 miliardi, intervallo aggiornato per includere l’onere legale. Escludendo quella voce, la società continua a prevedere per il 2026 un risultato operativo superiore a quello del 2025. Sono indicazioni prospettiche, non risultati già acquisiti, ma fissano il termine di confronto per i prossimi conti.

    Il Q3 2026 mostra un gruppo che usa l’intelligenza artificiale per rafforzare Facebook e Instagram, aumentare il valore pubblicitario della propria scala e sostenere la crescita di Threads e WhatsApp. Le piattaforme producono ancora quasi tutti i ricavi e finanziano l’infrastruttura su cui Meta vuole costruire Muse, i servizi per le imprese e la nuova generazione di dispositivi.

    Il dato mancante è altrettanto significativo di quelli pubblicati. Sappiamo quante persone hanno configurato Muse, quanto spesso una parte di loro lo utilizza e quali forme di monetizzazione Meta intende sperimentare. Non sappiamo quanto il prodotto incassi, quanto costi nel complesso e quale perdita generi.

    La verifica dei prossimi trimestri passerà quindi da due elementi. Il primo è la capacità delle attività principali di continuare a finanziare investimenti che hanno già portato il free cash flow sotto zero nel trimestre. Il secondo è il passaggio di Muse da prodotto con una partenza rapida a servizio globale con costi unitari, ricavi e margini leggibili.

  • Il fattore EEAT: come l’esperienza personale salverà la scrittura web dall’omologazione

    Il fattore EEAT: come l’esperienza personale salverà la scrittura web dall’omologazione

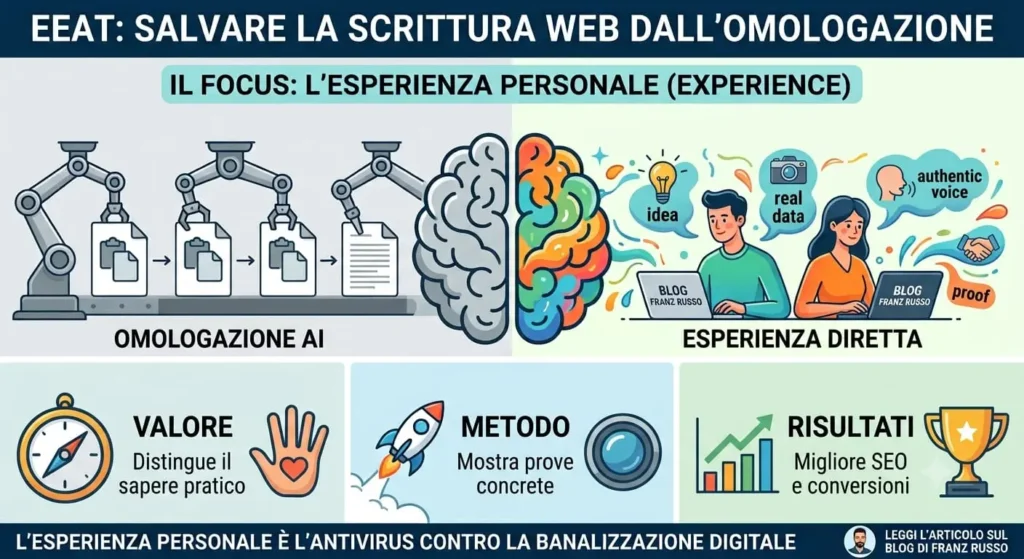
    Negli ultimi mesi è capitato spesso di trovare SERP piene di articoli visivamente impeccabili, grammaticalmente perfetti, ma irrimediabilmente vuoti. Il web si sta popolando di contenuti sintetici, generati in serie e fotocopiati tra loro. In questo panorama saturo e piatto, la vera differenza per posizionarsi su Google la fa una sola risorsa: l’esperienza vissuta sul campo.

    È qui che entra in gioco il concetto di EEAT, l’acronimo che ha ridefinito il modo in cui concepiamo l’ottimizzazione per i motori di ricerca e la stesura dei testi online.

    Non si tratta soltanto di un aggiornamento tecnico delle linee guida di Big G per i Quality Rater, ma di un vero e proprio salvagente per la scrittura web. Un parametro chiave capace di distinguere la conoscenza teorica da quella reale.

    Vediamo insieme come trasformare il fattore EEAT nel tuo miglior alleato strategico.

    Che cos’è l’EEAT di Google e perché la prima “E” cambia ogni prospettiva

    Per anni abbiamo parlato di EAT (Expertise, Authoritativeness, Trustworthiness), ossia Competenza, Autorevolezza e Affidabilità. Poi Google ha aggiunto una prima “E” fondamentale: Experience (Esperienza diretta).

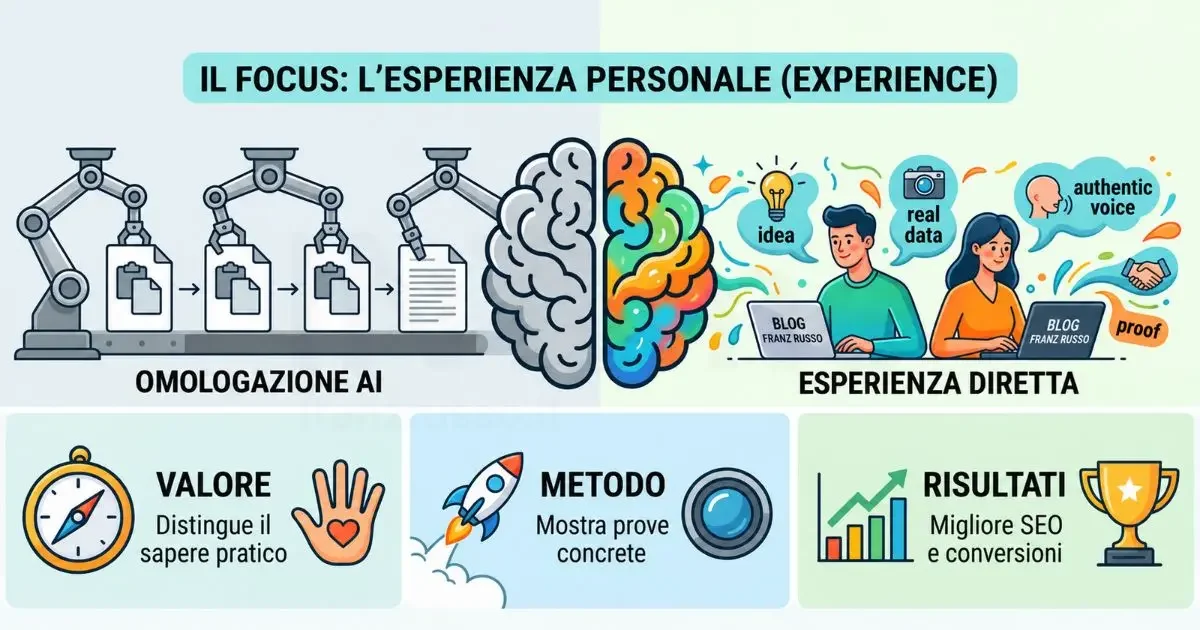
    Questa evoluzione non è casuale. Mentre la competenza rappresenta la nozione accademica o teorica, l’esperienza riguarda il “sapere pratico”, ovvero ciò che hai testato personalmente con mano, sbagliando e correggendo il tiro sul campo.

    Secondo te qual è la differenza tra un testo scritto rielaborando i concetti altrui e un contenuto intriso di pratica reale? Il secondo contiene sfumature, dati di prima mano e retroscena unici.

    Google premia questa prima “E” perché gli algoritmi riconoscono il valore irripetibile di chi ha risolto davvero un problema. L’esperienza personale diventa così l’unico vero antivirus contro la banalizzazione della scrittura digitale.

    Il fattore EEAT: come l'esperienza personale salverà la scrittura web dall'omologazione
    Il fattore EEAT: come l’esperienza personale salverà la scrittura web dall’omologazione

    Il rischio dell’omologazione con l’AI e il valore dell’esperienza umana

    L’accessibilità universale agli strumenti di intelligenza artificiale generativa ha provocato un fenomeno inevitabile: una standardizzazione globale dei contenuti web.

    Oggi chiunque può creare un testo di mille parole su argomenti complessi in una manciata di secondi.

    Ma il risultato quale sarà?

    Un’epidemia di articoli formattati allo stesso modo, che usano il medesimo tono di voce e dicono esattamente le stesse cose senza aggiungere mai un briciolo di valore originale.

    L’ultima tendenza che si può notare utilizzando uno strumento come Google Search Console è questa: i contenuti puramente teorici perdono visibilità nel tempo (e spesso nemmeno vengono più indicizzati), mentre quelli ricchi di elementi personali resistono agli aggiornamenti di algoritmo.

    Se chiedi a un software di spiegare come fare una ricerca di parole chiave, otterrai una sequenza logica di passaggi corretti. Se lo chiedo a te o se lo spiego io nel mio lavoro quotidiano, racconterò di quella volta che un volume di ricerca apparentemente insignificante ha generato conversioni record per un cliente grazie all’intento di ricerca specifico.

    Questo cambio di prospettiva trasforma un semplice articolo informativo in una risorsa preziosa e insostituibile per l’utente.

    Come applicare concretamente il principio EEAT nella stesura dei contenuti

    Integrare l’esperienza diretta nei propri testi richiede un cambio di mentalità operativo. Non basta inserire la parola chiave principale nei punti strategici del testo o curare la formattazione grafica; serve mostrare le prove di ciò che si afferma.

    Bisogna abituarsi a documentare il proprio lavoro quotidiano e trasformare la pratica professionale in un patrimonio narrativo condiviso.

    Per strutturare un contenuto capace di soddisfare pienamente le direttive del motore di ricerca e catturare l’attenzione dei lettori, è bene seguire sempre un processo in quattro fasi ben distinte:

    1. Selezione dell’argomento basata su problemi reali riscontrati con clienti o progetti interni.
    2. Raccolta di prove tangibili, come screenshot, grafici, statistiche proprietarie o aneddoti personali legati al processo.
    3. Redazione del testo integrando le parole chiave secondarie all’interno di un racconto fluido e incentrato sulla risoluzione del problema.
    4. Revisione critica del contenuto per eliminare ogni tipo di generalizzazione o frase fatta, assicurando un’utilità immediata.

    Questo approccio garantisce che ogni pagina pubblicata possieda un’impronta digitale unica. Inserire elementi di vita vissuta e casi di studio reali all’interno degli articoli non serve solo a compiacere gli algoritmi, ma crea un legame emotivo e professionale profondo con il lettore.

    Strategie pratiche per mostrare autorevolezza ed affidabilità al tuo pubblico

    Dimostrare il fattore EEAT significa anche prendersi cura della propria reputazione digitale e degli elementi strutturali del sito web.

    L’affidabilità (Trustworthiness) rimane il cuore centrale dell’intero concetto: se il lettore o il motore di ricerca non si fidano della fonte, l’esperienza e la competenza perdono gran parte del loro valore competitivo.

    Come rafforzare questa fiducia?

    • Di solito è buona norma firmare ogni contenuto con una biography dell’autore dettagliata e trasparente, includendo link ai profili social professionali.
    • Citare fonti ufficiali, studi di settore riconosciuti e documenti accademici per sostenere le affermazioni teoriche.
    • Inserire casi studio reali ed esempi pratici derivati dalla tua routine lavorativa o aziendale.
    • Mantenere aggiornati i vecchi contenuti inserendo nuove scoperte, correzioni o dati recenti relativi al settore.

    Implementare regolarmente questi piccoli accorgimenti permette di trasformare un semplice blog in un punto di riferimento credibile per la propria nicchia di mercato, proteggendo il traffico organico nel lungo periodo.

    La scrittura esperienziale come unica strada per distinguersi nel web del futuro

    Possiamo chiudere il cerchio dicendo che la crescita esponenziale dei contenuti generati in modo automatico non deve spaventare chi lavora con la scrittura web, ma rappresentare una straordinaria opportunità di posizionamento.

    La tecnologia può replicare la struttura grammaticale di un testo o riassumere nozioni già esistenti, ma non potrà mai simulare il vissuto, il senso critico e la sensibilità di un professionista che opera quotidianamente nel proprio settore.

    Integrare il parametro EEAT all’interno della propria strategia editoriale significa fare un patto di qualità con i lettori e con i motori di ricerca. Raccontare i dettagli del proprio lavoro, condividere gli errori commessi e spiegare le soluzioni adottate sul campo è l’unico modo per uscire dall’omologazione digitale.

    L’esperienza personale è l’asset più prezioso che possiedi: valorizzala e lasciala emergere in ogni singola riga.


    Cosa significa l’acronimo EEAT per Google?

    L’acronimo EEAT significa Experience, Expertise, Authoritativeness e Trustworthiness (Esperienza, Competenza, Autorevolezza e Affidabilità). Indica l’insieme di linee guida utilizzate dai valutatori di qualità di Google per giudicare l’affidabilità, il valore e l’accuratezza dei contenuti pubblicati sulle pagine web.

    L’EEAT è un fattore di posizionamento diretto nei sistemi di Google?

    No, il parametro EEAT non è un fattore di ranking algoritmico diretto con un punteggio numerico. Rappresenta una serie di segnali che i sistemi di ricerca Google cercano di misurare per premiare contenuti autorevoli, utili e creati da esperti con reale esperienza diretta.

    Come posso mostrare la mia esperienza personale nei testi SEO?

    Puoi dimostrare l’esperienza personale citando casi reali, inserendo immagini o screenshot di progetti gestiti e raccontando sfide lavorative superate. Utilizzare l’analisi di dati di prima mano rende ogni testo unico, autorevole e perfettamente coerente con i principi del modello EEAT.

    Qual è la differenza sostanziale tra Experience ed Expertise?

    L’Expertise riguarda la conoscenza teorica e le credenziali formali su un tema. L’Experience, introdotta nel concetto di EEAT, riguarda invece l’esperienza pratica sul campo: la dimostrazione di aver utilizzato davvero un prodotto, visitato un luogo o risolto concretamente un problema tecnico.

    Cosa si intende per SERP?

    La SERP, cioè Search Engine Results Page, è la pagina dei risultati che Google restituisce dopo una ricerca. È lo spazio in cui i contenuti competono per la visibilità, e la sua composizione cambia a seconda del tipo di domanda posta dall’utente.

    Chi sono i Quality Rater?

    I valutatori della qualità di ricerca sono persone incaricate da Google di giudicare la qualità delle pagine seguendo linee guida pubbliche. Non hanno alcun controllo diretto sul ranking: il loro giudizio serve come feedback per verificare se i sistemi automatici stanno funzionando. Questa definizione poggia sulla pagina Google che hai appena linkato, che dice esattamente questo, quindi è verificata.

  • Muse Image, l’Intelligenza Artificiale di Meta entra nella creazione dei contenuti

    Muse Image, l’Intelligenza Artificiale di Meta entra nella creazione dei contenuti

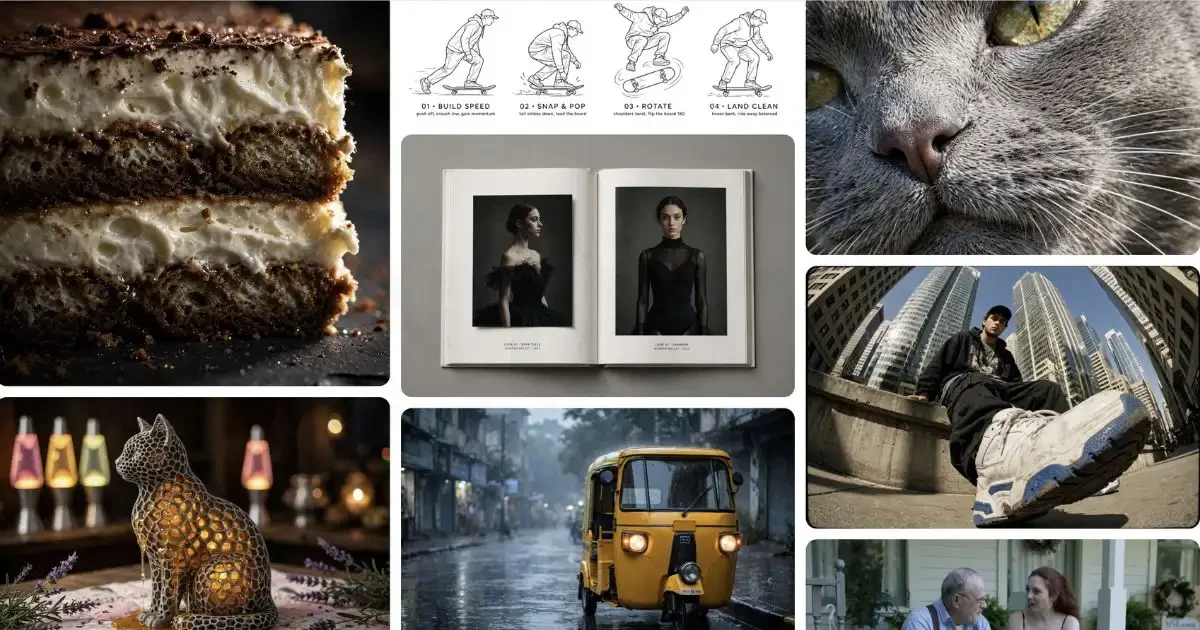
    Meta lancia Muse Image, il suo primo modello di generazione di immagini firmato Meta Superintelligence Labs, e lo porta subito dentro Instagram Stories e WhatsApp. In anteprima arriva anche Muse Video. Il modello lavora in modo agentico, usa strumenti di ricerca e di coding e si autocorregge da solo.

    Dopo il lancio del Superintelligence Lab, avvenuto ad aprile scorso, ecco che Meta si lancia nel grande mondo della IA generativa, facendo un salto di qualità notevole. La società di Zuckerberg quindi, dopo tante fasi altalenanti, e tanti investimenti, decide di entrare in competizione diretta con Grok (modello di xAI alla base di X) e anche con ChatGPT e Gemini. Proprio nella generazione delle immagini.

    Infatti ieri, 7 luglio 2026, Meta ha annunciato Muse Image, il suo primo modello di generazione di immagini, e ha presentato in anteprima Muse Video, il modello gemello per i contenuti in movimento.

    Si tratta dei primi prodotti di generazione di contenuti firmati Meta Superintelligence Labs, la divisione di ricerca guidata da Alexandr Wang, primo Chief AI Officer nella storia dell’azienda.

    E non si tratta di un rilascio isolato. Come già raccontato sempre ad aprile, Muse Spark era stato il primo modello costruito da zero dal nuovo laboratorio. Muse Image, quindi, ne è la naturale prosecuzione, applicata questa volta alla generazione visiva.

    Muse Image, l'Intelligenza Artificiale di Meta entra nella creazione dei contenuti
    Muse Image, l’Intelligenza Artificiale di Meta entra nella creazione dei contenuti

    Meta Superintelligence Labs e la logica agentica di Muse Image

    Va sottolineato un elemento che distingue Muse Image dalla maggior parte dei generatori di immagini che abbiamo imparato a conoscere negli ultimi anni. Il modello di Meta non si limita a tradurre un prompt (indicazione o comando testuale) in un’immagine in un solo passaggio. Funziona, dice il colosso di Menlo Park, in modo agentico. Significa che il modello pianifica, usa strumenti esterni, valuta il proprio lavoro e lo corregge prima di consegnarlo.

    Durante l’addestramento con apprendimento per rinforzo (tecnica di machine learning), il modello ha imparato a scrivere ed eseguire codice per produrre grafici accurati o QR code funzionanti, e a cercare sul web per ancorare le immagini generate a informazioni reali e aggiornate, specialmente su temi legati all’attualità.

    In combinazione con Muse Spark, la stessa capacità di scrivere codice arriva a produrre GIF animate, siti con immagini incorporate e persino giochi visivi interattivi. Meta sostiene inoltre che la capacità di ricerca migliori sensibilmente l’accuratezza fattuale delle immagini prodotte, un problema che ha sempre accompagnato i generatori come questi.

    L’azione di autocorrezione di Muse Image

    Ma il dettaglio più interessante è un altro. Muse Image mostra un comportamento di auto-correzione che, stando a quanto scrive Meta, non è stato progettato in precedenza. Infatti, è emerso in maniera naturale durante l’addestramento, perché produceva immagini migliori e quindi un punteggio di ricompensa più alto. In pratica il modello rilegge il proprio lavoro nella catena di ragionamento e decide se serve una piccola modifica, una generazione da capo, o un cambio di strategia più radicale.

    A questo si aggiunge la scalabilità del calcolo in fase di inferenza: più tempo e risorse il modello impiega a “pensare”, tra ragionamento testuale, chiamate a strumenti esterni e passaggi di autocorrezione, più il risultato migliora. Di conseguenza, i miglioramenti crescono via via più lentamente man mano che si aggiunge calcolo.

    Interessante notare che, secondo i test interni dell’azienda, generare più immagini e scegliere la migliore (la tecnica nota come best-of-N, quando il modello genera più immagini da uno stesso prompt) funziona bene solo all’inizio e si esaurisce in fretta, mentre investire lo stesso calcolo in ragionamento deliberato continua a produrre miglioramenti.

    Editing di precisione e composizione da più riferimenti

    Muse Image punta molto sull’editing controllato. Il modello, spiega Meta, modifica esattamente quello che l’utente chiede, mantenendo coerenza tra i vari passaggi di un editing iterativo, così da permettere modifiche successive senza perdere il contesto delle precedenti.

    Si può chiedere di rimuovere un elemento indesiderato da una fotografia, mettersi virtualmente davanti a un monumento storico, o costruire un QR code funzionante partendo da un semplice prompt testuale.

    C’è poi la composizione multi-riferimento: Muse Image può combinare elementi provenienti da più immagini di input, persone, oggetti, abiti, stili, ambienti, interpretando prompt che alternano testo e immagini per costruire composizioni complesse. Ed è qui che il modello si appoggia esplicitamente a Instagram per il contesto social, un’integrazione che nessun concorrente diretto può replicare con la stessa profondità, semplicemente perché nessun concorrente possiede una piattaforma social media di quelle dimensioni.

    Muse Image, l'Intelligenza Artificiale di Meta entra nella creazione dei contenuti
    Muse Image, come si presenta

    Dove è attivo Muse Image e dove arriverà

    Muse Image è disponibile da subito nell’app Meta AI e su meta.ai, nelle Instagram Stories negli Stati Uniti e su WhatsApp in un numero limitato di Paesi. Meta ha annunciato che arriverà presto anche su Facebook. L’uso per la “creazione quotidiana” resta gratuito, ma oltre una certa soglia serve un abbonamento ai piani a pagamento di Meta.

    Gli usi che Meta stessa mostra vanno oltre il semplice intrattenimento. Si va dalla creazione di asset di marketing per piccole imprese alla possibilità, integrata con Facebook Marketplace, di visualizzare come apparirebbe in salotto un divano prima di acquistarlo. In buona sostanza, Meta sta provando a portare la generazione di immagini dentro i flussi di lavoro quotidiani delle persone e delle aziende, non solo dentro un’app dedicata.

    E posso confermare da esperienza diretta che Muse Image funziona su meta.ai anche dall’Italia. Contrariamente a quanto si potrebbe pensare, l’accesso di base al modello non è affatto bloccato: la limitazione geografica riguarda solo l’integrazione nelle Instagram Stories, per ora riservata agli Stati Uniti, e in parte WhatsApp.

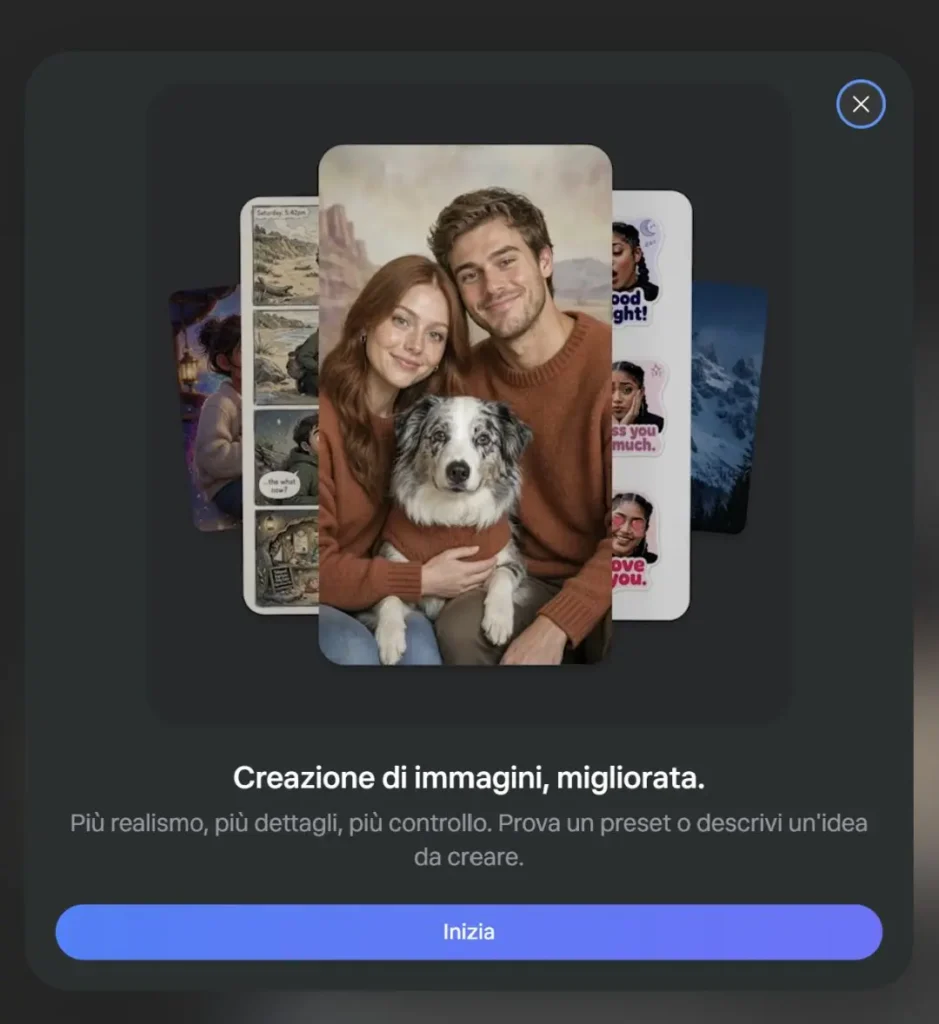
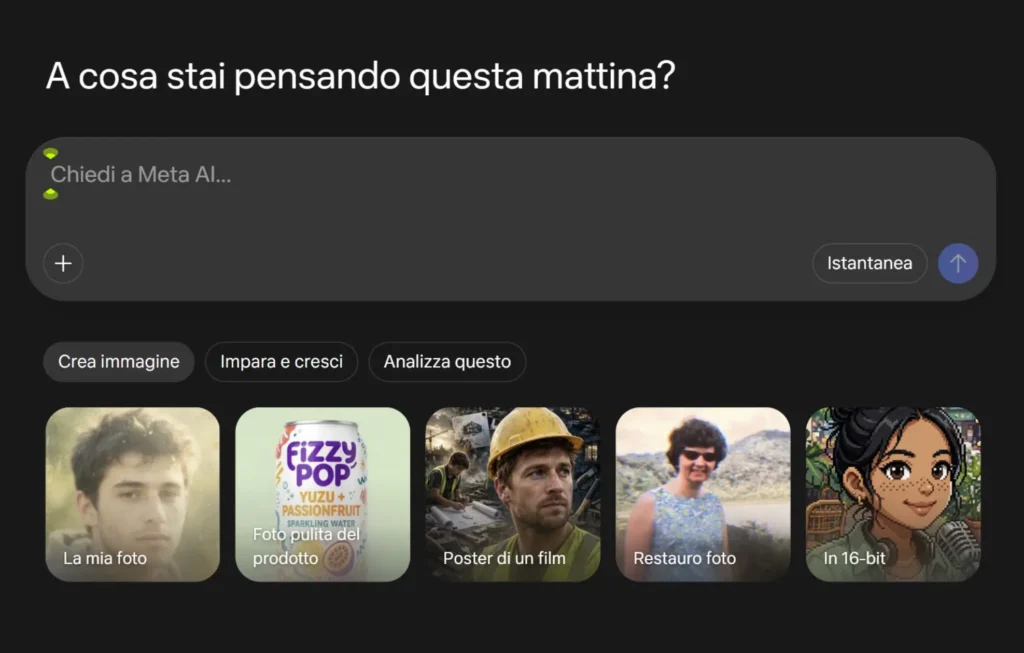
    L’interfaccia si presenta con una domanda semplice, “A cosa stai pensando questa mattina?”, e tre modalità tra cui “Crea immagine”, accompagnata da una serie di preset con anteprima reale: “La mia foto”, “Foto pulita del prodotto”, “Poster di un film”, “Restauro foto”, “In 16-bit”.

    Al primo utilizzo compare anche un messaggio di benvenuto, “Creazione di immagini, migliorata. Più realismo, più dettagli, più controllo”, che invita a provare un preset o a descrivere direttamente un’idea.

    Muse Image, l'Intelligenza Artificiale di Meta entra nella creazione dei contenuti
    Muse Image, come funziona

    C’è un dettaglio che salta all’occhio più di ogni altro: da nessuna parte, in questa interfaccia, compare il nome Muse Image. Per chi la usa, resta semplicemente Meta AI, un po’ più capace di ieri. Ed è forse la conferma più chiara della tesi con cui abbiamo aperto: l’intelligenza artificiale generativa entra nei nostri strumenti quotidiani proprio perché non si fa notare.

    Restano poi alcuni dettagli pratici raccolti nelle prime ore dopo il lancio, da prendere con la dovuta cautela trattandosi di indicazioni ancora parziali. Oltre al prompt testuale, Muse Image permetterebbe di disegnare o scrivere a mano libera direttamente sulla foto per indicare cosa modificare.

    Il progetto, se ricordate anche voi, era conosciuto internamente con il nome in codice Mango. E l’abbonamento a pagamento necessario oltre la soglia gratuita è quello di Meta One, con limiti che variano da servizio a servizio e da Paese a Paese.

    Le IG Stories cambiano volto, con nuovi effetti

    Parallelamente al lancio di Muse Image, Instagram ha introdotto oltre trenta nuovi effetti per le Stories, tutti alimentati dal nuovo modello. Adam Mosseri, a capo di Instagram, li ha presentati lui stesso su Threads, citando effetti come Disposable (monouso) e Night Flash (flash di notte), che trasformano la luce delle fotografie, oppure Instagram Charms e Instagram Receipt, effetti personalizzati costruiti sul profilo di chi li usa.

    E, ha aggiunto Mosseri, chi vuole può anche crearsi un effetto su misura scrivendo semplicemente un prompt: è proprio questa la funzione che, a suo dire, è più curioso di vedere sperimentata dagli utenti.

    L’editor delle Stories si è aggiornato di conseguenza, mostrando un’anteprima di ogni effetto prima di applicarlo. È quindi una funzione che, negli Stati Uniti per ora, milioni di persone si troveranno semplicemente dentro l’app, senza dover cercare nulla.

    Il posizionamento competitivo: dietro OpenAI, avanti a Google

    Meta non si è sottratta al confronto diretto con i rivali. Sulla piattaforma Arena, che misura le preferenze umane tra modelli concorrenti, Muse Image occupa al momento il secondo posto nelle classifiche per generazione testo-immagine, editing di una singola immagine ed editing multi-immagine.

    Da benchmark interni diffusi dalla stessa azienda, il modello risulterebbe dietro a GPT Image 2 di OpenAI ma davanti a Nano Banana 2 di Google nei compiti di editing. Va detto, come sempre in questi casi, che si tratta di numeri forniti dall’azienda stessa: le classifiche Arena sono comunque un riferimento pubblico e verificabile, ma la lettura competitiva resta quella di Meta.

    Su Muse Video, ancora in anteprima e non disponibile al pubblico, Meta rivendica una performance competitiva su fedeltà visiva e aderenza al prompt, con audio nativo integrato fin da questa prima versione. Restano margini di miglioramento dichiarati su sincronizzazione audio-video e movimento fisico rapido. Sempre su Arena, il modello si posiziona al terzo posto per la generazione testo-video.

    Content Seal, la firma di Meta AI

    Ogni immagine generata con Muse Image nell’app Meta AI e su meta.ai porta con sé un segnale di provenienza invisibile, chiamato Content Seal, pensato per resistere a ritagli, compressioni, ridimensionamenti e persino screenshot.

    Meta ha annunciato anche uno strumento, ancora in anteprima, che permette di verificare se un’immagine porta questo tipo di filigrana, e ha promesso di estendere il sistema anche ai video. È una risposta, seppure parziale, a una domanda che si pone ogni volta che un’azienda mette nelle mani di milioni di persone uno strumento capace di generare immagini fotorealistiche: come distinguere cosa è stato creato da una IA.

    Il tag automatico sulle foto pubbliche, e la scelta del default

    C’è un aspetto, in questo lancio, che merita un chiarimento specifico, perché riguarda direttamente chi su Instagram ha un profilo pubblico. Muse Image permette di generare immagini a partire dal profilo di un altro utente semplicemente taggandolo con la chiocciola.

    E questa possibilità, per gli account pubblici, è attiva di default: non è l’utente a doverla attivare, ma eventualmente a doverla spegnere. Una pagina di supporto di Meta chiarisce inoltre che chi vede le proprie foto usate in questo modo non riceve alcuna notifica.

    Per disattivare la funzione bisogna entrare nel proprio profilo Instagram, aprire il menu in alto a destra, andare su “Condivisione e riutilizzo” e togliere la spunta a “Post” e “Reel” nella sezione che consente alle persone di usare i propri contenuti su Instagram e con le funzioni IA di Meta. Va specificato, per completezza, che disattivare l’opzione blocca solo le generazioni future, significa che le immagini già create restano.

    Non si tratta di una funzione nascosta o segreta, e Meta la presenta apertamente come un modo per creare contenuti “con gli amici” o per reimmaginare le proprie foto. Ma una cosa è offrire uno strumento di creazione condivisa, un’altra è farlo partendo da un’impostazione che richiede un’azione attiva per essere disattivata, invece che per essere attivata.

    In conclusione

    Muse Image arriva in un momento in cui la corsa alla generazione di immagini e video con l’IA è ormai affollata, tra OpenAI, Google e i tanti modelli, anche più piccoli, che si contendono lo stesso spazio.

    Ma quello che rende questo lancio diverso non è solo la qualità tecnica del modello, su cui peraltro Meta stessa ammette di non essere ancora prima. È la scala con cui viene distribuito: dentro Instagram, dentro WhatsApp, dentro Facebook Marketplace, cioè dentro le abitudini quotidiane di miliardi di persone, non in un’app a parte che bisogna scegliere di scaricare.

    Resta da vedere se lo stesso approccio, applicato anche al tag automatico e ai default di consenso, reggerà alla prova del tempo e dell’attenzione dei regolatori europei, abituati ormai a guardare con sospetto ogni impostazione che scarica sull’utente l’onere di proteggersi.

    Vedremo come andrà e intanto, se vi va, fatemi sapere se avete iniziato ad usarla e cosa ne pensate.

  • WhatsApp e gli username, ecco come funziona la prenotazione

    WhatsApp e gli username, ecco come funziona la prenotazione

    Annunciati da tempo, Meta ha rilasciato gli username su WhatsApp per usare l’app senza condividere il numero di telefono. La prenotazione è aperta anche in Italia, ma compare nell’app solo dopo una notifica dedicata.

    Meta annuncia gli username su WhatsApp e apre la prenotazione con mesi di anticipo sul lancio della funzione. La ragione è dichiarata nel comunicato stesso. Con oltre tre miliardi di persone sulla piattaforma, molti nomi finiranno per coincidere, e l’azienda vuole che ciascuno possa scegliere il proprio prima della corsa.

    Una funzione pensata per la tutela della privacy

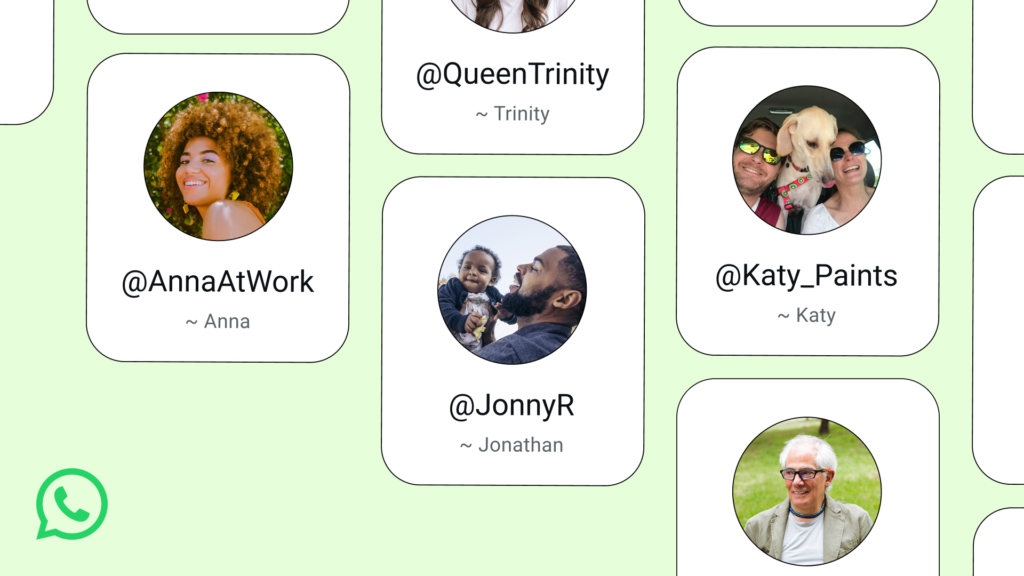
    WhatsApp introduce gli username come una funzione importante per la tutela della privacy, pensata per consentire a chi non si conosce ancora di scriversi senza scambiarsi il numero di telefono.

    Il ragionamento fatto a Menlo Park parte proprio dal numero di telefono e dal suo valore.

    Infatti, un numero di telefono è personale ed è legato ormai a tante parti della vita di chi lo possiede. E a volte ci basta chattare, senza doverlo per forza condividere con altri. Vale per le persone che entrano nella nostra vita, un compagno di classe, un vicino, qualcuno conosciuto a un incontro tra amici.

    E vale per le conversazioni di gruppo, dove l’esempio scelto da Meta è la chat dei genitori della squadra di calcio dei propri figli, quando si vuole partecipare senza condividere il numero con sconosciuti. Un ragionamento questo che vale per tutti i gruppi a cui, spesso, si viene iscritto senza nemmeno una preventiva richiesta.

    WhatsApp e gli username, ecco come funziona la prenotazione
    WhatsApp e gli username, ecco come funziona la prenotazione

    La prenotazione arriva prima lancio ufficiale

    Da questa settimana, dunque, è possibile prenotare il proprio username, da usare poi più avanti nel corso dell’anno, quando Meta lancerà ufficialmente la funzione.

    La ragione della prenotazione anticipata è dichiarata proprio da Meta. Con oltre tre miliardi di persone su WhatsApp, molti nomi finiranno per coincidere, e l’azienda apre le prenotazioni in anticipo per dare a ciascuno la possibilità di scegliere lo username a cui tiene in modo particolare. Anche per preservare e consolidare la propria presenza digitale.

    Il percorso da seguire nell’app è: Impostazioni > Account > Nome utente, sull’ultima versione della stessa app.

    Per chi non sapesse cosa scegliere, c’è un generatore di username all’interno dell’app. E c’è un’opzione dedicata a creator, piccole imprese e organizzazioni che vogliono mantenere una presenza riconoscibile sui social, ovvero la possibilità di rivendicare su WhatsApp lo stesso username già usato su Instagram o Facebook. Quello a cui facevo riferimento prima per consolidare la propria presenza digitale anche sulle piattaforme.

    Nessuno elenco di username su WhatsApp

    Meta fa sapere anche cosa la nuova funzione non farà, ed è un passaggio importante su cui soffermarsi un attimo.

    E cioè che su WhatsApp non esisterà nessun elenco pubblico di username da sfogliare, e l’app non suggerirà profili di altre persone.

    Se vogliamo scrivere a qualcuno per la prima volta, dobbiamo già conoscere il suo username esatto, perché ce l’ha detto lui. È una scelta che protegge il senso stesso della funzione, lo username resta un dato che si condivide solo con chi si vuole davvero.

    A questo Meta aggiunge un secondo livello di protezione, opzionale, che chiama chiave dello username.

    In pratica, una volta attivata la chiave, gli altri utenti per scriverti dovranno conoscere non solo il tuo username, ma anche la chiave stessa.

    Username su WhatsApp
    Username su WhatsApp

    Si tratta quindi di un filtro in più che decide l’utente se attivare o meno.

    Il risultato finale, quando la funzione sarà davvero attiva, è che chi ti scrive per la prima volta vedrà il tuo username e non il tuo numero di telefono, a patto naturalmente che lo username sia attivato.

    Username su WhatsApp, non mancano le critiche

    Sotto il post di lancio di WhatsApp su X non sono mancate le critiche. In sintesi secondo molti utenti, quello degli username su WhatsApp sarebbe un grande schema di raccolta e aggregazione di dati, il cui obiettivo è spingere gli utenti a collegare gli account social tra WhatsApp e Instagram per migliorare la profilazione pubblicitaria, e quindi i ricavi di Meta.

    L’apertura anticipata della prenotazione, secondo questa lettura, sfrutta la FOMO dei consumatori per indurli ad accaparrarsi rapidamente il nome utente preferito.

    WhatsApp ha risposto in pubblico, sempre su X, dal suo account ufficiale.

    Secondo la piattaforma di messaggistica, il nome utente non ha nulla a che fare con la pubblicità e la funzione è completamente facoltativa. La maggior parte degli utenti sceglierà nomi unici, mentre l’opzione di rivendicare lo stesso nome già usato su Instagram o Facebook serve ad alcune aziende e persone che desiderano coerenza nel modo in cui si presentano sulle diverse app.

    WhatsApp ribadisce poi quanto già scritto nel comunicato, non ci sarà alcun elenco pubblico, non ci saranno suggerimenti, e per scrivere a qualcuno servirà conoscere il suo nome utente esatto, oltre alla chiave del nome utente se attivata. Vale a dire quello che è scritto anche qui in questo articolo.

    Il rilascio dello username su WhatsApp sarà graduale

    Sul rilascio Meta è esplicita. Gli username saranno distribuiti gradualmente nei prossimi mesi, con una notifica dentro WhatsApp quando saranno disponibili nel proprio paese.

    In buona sostanza, la prenotazione è già aperta per chi ha l’ultima versione dell’app, ma l’uso effettivo della funzione arriverà più avanti, e arriverà in maniera graduale, paese per paese.


    Alcuni passaggi per chiarire meglio:

    Cosa sono gli username di WhatsApp?
    Sono una funzione per la tutela della privacy, annunciata da Meta il 29 giugno 2026, che permette a due persone di scriversi su WhatsApp senza doversi scambiare il numero di telefono.

    Come si prenota uno username su WhatsApp?
    Sull’ultima versione dell’app, seguendo il percorso Impostazioni > Account > Nome utente. Per chi non sa cosa scegliere, WhatsApp mette a disposizione un generatore di username già presente nell’app.

    Perché Meta apre la prenotazione prima del lancio della funzione?
    Perché su WhatsApp ci sono oltre tre miliardi di persone, e molti nomi finiranno per coincidere. La prenotazione anticipata serve a dare a ciascuno la possibilità di scegliere lo username a cui tiene davvero, prima che lo prenda qualcun altro.

    Quando partirà la funzione vera e propria?
    Più avanti nel corso del 2026. Meta apre la prenotazione da questa settimana, ma l’uso effettivo della funzione arriverà nei mesi successivi.

    La funzione è già disponibile in Italia?
    Meta dichiara che gli username saranno distribuiti gradualmente nei prossimi mesi, e che gli utenti riceveranno una notifica dentro WhatsApp quando la funzione sarà disponibile nel proprio Paese.

    Cos’è la chiave del nome utente di WhatsApp?
    È un secondo livello di protezione, opzionale, che si affianca allo username. Se la attivi, chi vuole scriverti deve conoscere non solo il tuo username ma anche questa chiave. Funziona come un filtro in più, che decidi tu se mettere o no.

    Esiste un elenco pubblico per cercare gli username?
    No. Meta scrive nel comunicato che non ci sarà nessun elenco pubblico da sfogliare, e che WhatsApp non suggerirà profili di altre persone. Per scrivere a qualcuno la prima volta, bisogna già conoscere il suo username esatto.

    Con gli username il numero di telefono resta visibile?
    Quando la funzione sarà attiva, chi ti scrive per la prima volta vedrà il tuo username e non il tuo numero di telefono, a condizione che tu abbia attivato lo username sul tuo profilo.

    Creator e aziende possono mantenere lo stesso username di Instagram?
    Sì. Meta riserva un’opzione dedicata a creator, piccole imprese e organizzazioni, per rivendicare su WhatsApp lo stesso username già usato su Instagram o Facebook.

  • Come cambia l’ottimizzazione SEO per AI e cosa resta del fattore umano

    Come cambia l’ottimizzazione SEO per AI e cosa resta del fattore umano

    L’ottimizzazione SEO per AI non è la fine della scrittura, ma una nuova consapevolezza. Tra AI Mode, AI Overview e GEO vince chi intercetta l’intenzione delle persone e porta esperienza e voce umana dentro i contenuti, là dove la macchina non arriva.

    Oggi parlare di ottimizzazione SEO per AI significa innanzitutto comprendere che non stiamo assistendo alla fine della scrittura, ma alla nascita di una nuova consapevolezza.

    L’intelligenza artificiale ha invaso i flussi di lavoro e la creazione di contenuti, ma questo non deve spaventare chi mette al centro la qualità.

    La sfida non è combattere la tecnologia, ma capire come evolve il comportamento delle persone che la utilizzano.

    Oltre le parole chiave: la SEO per AI Mode

    Il primo grande cambiamento riguarda il modo in cui gli utenti interagiscono con la rete.

    Siamo entrati nell’era (e sapevamo sarebbe arrivato il momento!) della “SEO per AI Mode”, una modalità di ricerca in cui le persone non si limitano più a digitare due o tre parole isolate, ma dialogano, fanno domande complesse e cercano risposte articolate.

    Questo significa che la vecchia abitudine di scrivere testi inserendo meccanicamente una lista di parole chiave per far felice un algoritmo è definitivamente tramontata (per la gioia o il dolore di alcuni): oggi vince chi sa intercettare l’intenzione profonda che si nasconde dietro ogni singola domanda.

    Per capire quanto questa rivoluzione sia profonda, provo a fare un piccolo salto indietro nel tempo.

    Ricordo ancora quando, anni fa, fare una ricerca su Google sembrava quasi un esercizio di traduzione “uomo-macchina”.

    Se cercavamo un ristorante per una cena tra amici, digitavamo cose telegrafiche come “ristorante pesce Milano centro”.

    Eravamo noi a doverci adattare al linguaggio rigido del motore di ricerca, sperando che sputasse fuori la pagina giusta.

    Oggi, se osservo come le persone usano lo smartphone (e confesso, lo faccio spesso anche io quando cerco l’ispirazione per i miei progetti) lo scenario è completamente stravolto.

    Non scriviamo più per formule.

    Apriamo la chat di un’AI o usiamo la ricerca vocale mentre magari stiamo cucinando o camminando per strada, ed esordiamo con:

    “Senti, stasera ho a cena un amico che è intollerante al glutine ma ama i piatti della tradizione. Mi trovi un posto tranquillo a Milano dove si possa parlare senza urlare e che abbia una buona carta dei vini?”

    Questa non è più una stringa di parole chiave. È una conversazione. È la descrizione dettagliata di un bisogno, di uno stato d’animo, di un contesto.

    Ed è proprio qui che si attiva la SEO per AI Mode: i nuovi sistemi non scompongono più questa frase in singoli pezzi per fare il match con un testo che contiene esattamente quelle parole.

    Al contrario, cercano di comprendere il perché di quella richiesta.

    Capiscono che “amico” e “poter parlare” significano che l’utente ha bisogno di un’atmosfera informale e silenziosa, non di una pizzeria caotica, anche se magari quella pizzeria fa un’ottima cucina senza glutine.

    Scrivere contenuti oggi, quindi, non significa più riempire una pagina di termini tecnici ripetuti fino alla nausea per scalare una classifica. Significa fare un lavoro di vera e propria empatia digitale.

    Significa anticipare quelle sfumature, rispondere ai dubbi che il lettore non ha ancora formulato chiaramente nella sua testa, e farlo con una naturalezza tale che sia le persone, sia l’intelligenza artificiale che analizza il testo per dare una risposta, possano dire: “Sì, è esattamente questo quello che stavo cercando”.

    Come cambia ottimizzazione SEO AI cosa resta del fattore umano
    Come cambia l’ottimizzazione SEO per AI e cosa resta del fattore umano

    Le risposte dirette e la SEO per AI Overview

    Un esempio chiarissimo di questa trasformazione è visibile nei motori di ricerca, dove lo spazio per i tradizionali link blu si sta riducendo a favore di sintesi generate direttamente dagli algoritmi.

    Fare i conti con la SEO per AI Overview non significa arrendersi del tutto alla perdita di clic, ma capire come diventare la fonte autorevole a cui l’intelligenza artificiale attinge per formulare quelle stesse risposte.

    Per farlo, non servono trucchi tecnici, ma la capacità di strutturare i contenuti in modo chiaro, rispondendo in modo diretto e trasparente ai bisogni reali del pubblico.

    Diciamoci la verità: la prima volta che ho visto una di queste grandi scatole colorate in cima alla pagina di ricerca, con il testo già pronto e i nostri amati link racchiusi in piccoli quadratini sullo sfondo, ho provato una stretta allo stomaco.

    Per chi vive di contenuti, quella schermata ha l’effetto di un piccolo terremoto.

    La reazione d’istinto di molti colleghi è stata il panico: “Ecco, se l’utente trova già la risposta pronta, non cliccherà mai più sul mio sito. Il traffico crollerà. È la fine”.

    Ma poi ho fatto un respiro profondo e ho iniziato a osservare la cosa da un’altra prospettiva.

    Se l’AI Overview riassume i dati per l’utente, da dove prende quelle informazioni? Non le inventa dal nulla. Le attinge da chi quelle cose le ha scritte prima, meglio e con più autorevolezza di altri.

    Però, dobbiamo cambiare il modo in cui impaginiamo e pensiamo i nostri articoli. Non possiamo più permetterci di essere “fumosi” o di allungare il brodo solo per fare minutaggio sulla pagina.

    L’intelligenza artificiale ha fretta e cerca la sostanza. Se un utente cerca come risolvere un problema specifico, non dobbiamo costringerlo a leggere tre paragrafi di introduzione storica prima di arrivare al punto.

    Dobbiamo essere diretti: dare la risposta subito, in modo limpido, e poi approfondire il come e il perché.

    Una nuova figura professionale: la consulenza SEO per AI

    In questo scenario così fluido, anche il ruolo dei professionisti della comunicazione sta cambiando radicalmente.

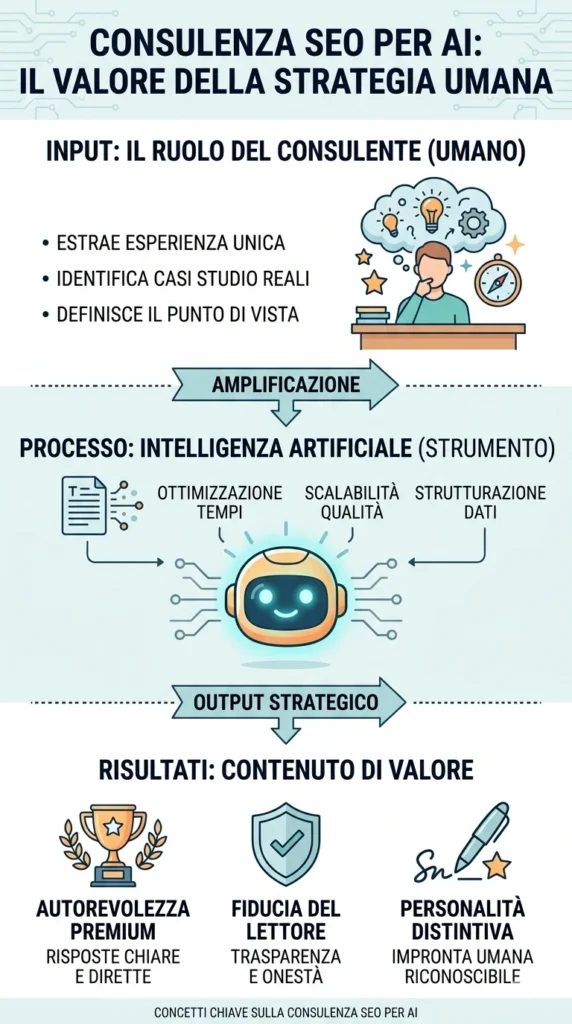
    Chi si occupa di strategia non può più limitarsi a consegnare report di parole chiave, ma deve offrire una vera e propria consulenza SEO per AI.

    Questo significa guidare le aziende a comprendere che l’AI è un amplificatore: se inserisci nel sistema un’idea banale, otterrai un testo banale in pochi secondi; se invece porti valore, esperienza vissuta e un punto di vista unico, l’intelligenza artificiale diventa un alleato prezioso per ottimizzare i tempi e scalare la qualità.

    A me capita sempre più spesso durante i primi incontri con i clienti: arrivano con gli occhi affamati di fronte alla prospettiva di poter produrre centinaia di articoli con un clic, convinti che la SEO si sia trasformata in un gioco di pura velocità.

    Il mio compito, oggi, inizia quasi sempre smontando questa illusione. Ricordo un piccolo imprenditore che, con orgoglio, mi mostrò un intero piano editoriale generato in una mattina con un software di intelligenza artificiale.

    I testi erano grammaticalmente perfetti, ma leggendoli sembrava di scorrere un’enciclopedia degli anni ’90: freddi, impersonali, piatti. Non c’era traccia della sua passione, dei problemi reali dei suoi clienti, delle soluzioni uniche che la sua azienda offriva ogni giorno.

    Gli dissi una cosa che oggi è diventata il mio mantra come Seo Copywriter Freelance:

    ottimizzazione seo per AI

    “L’intelligenza artificiale è un amplificatore eccezionale, ma amplifica solo quello che decidi di metterci dentro. Se gli dai in pasto la banalità, produrrà spazzatura digitale alla velocità della luce. Se invece le offri la tua esperienza vissuta, il tuo punto di vista e la tua unicità, si trasformerà nella tua più grande alleata”.

    La guida pratica: come fare SEO per AI

    Ma all’atto pratico, come fare SEO per AI senza perdere l’anima e l’identità della propria scrittura? La risposta sta nella semplicità delle linee guida Google che egli stesso suggeriscono: focalizzarsi sull’esperienza e sull’autorevolezza.

    Per spiegarlo, mi piace usare una metafora culinaria che uso spesso anche quando mi trovo a pianificare i contenuti con i miei clienti.

    Pensiamo all’AI come a un robot da cucina di ultima generazione: può tagliare, impastare e cuocere alla perfezione, ma se gli ingredienti che ci mettiamo dentro non hanno sapore, il piatto finale sarà insipido.

    La ricetta per farsi amare dagli algoritmi oggi si basa su tre ingredienti segreti che nessuna macchina possiede di serie:

    • L’ascolto attivo (la materia prima): non partiamo dai dati dei software, ma dalle persone e questa è una cosa alla quale tengo sempre tanto. Quali sono i dubbi reali che un cliente ti fa al telefono? Quali paure lo bloccano prima di acquistare? Rispondere a queste domande significa creare contenuti che le persone cercano disperatamente e che l’AI raccoglierà come oro colato.
    • L’esperienza diretta (il sapore): racconta come hai risolto quel problema specifico. Inserisci i tuoi fallimenti, i tuoi successi, i dati reali del tuo lavoro. Quando scrivi “ho testato questa strategia per tre mesi e questo è quello che è successo”, stai dando a Google e all’utente qualcosa di unico, che nessun modello linguistico può generare dal nulla perché non ha mai vissuto un giorno nel mondo reale.
    • La chiarezza espositiva (la presentazione): l’intelligenza artificiale ha bisogno di ordine per capire. Usare titoli chiari, elenchi puntati e frasi brevi non serve solo a rendere il testo leggibile per un utente distratto sullo smartphone, ma aiuta l’algoritmo a mappare i concetti in un millisecondo, eleggendoti a fonte affidabile.

    Il futuro della scrittura: l’ottimizzazione SEO per AI

    Guardando al domani, l’ottimizzazione SEO per AI non sarà un insieme di regole matematiche, ma la capacità di mantenere un equilibrio perfetto tra l’efficienza tecnologica e l’empatia umana.

    In un web potenzialmente sommerso da contenuti impeccabili ma tutti uguali, l’autenticità, la firma e la personalità del brand diventeranno il vero lusso e il principale fattore di posizionamento.

    Se devo fare una previsione per il prossimo futuro, vedo una netta divisione nel mercato.

    Da un lato ci sarà un rumore di fondo assordante: milioni di siti web che pubblicano testi fotocopia, scritti da macchine per altre macchine, in una rincorsa al clic che non genera alcun valore reale.

    Dall’altro lato, ci saranno le oasi felici: professionisti e brand che useranno l’ottimizzazione non per nascondersi dietro un algoritmo, ma per far emergere la propria voce.

    Il futuro della SEO appartiene a chi accetta la sfida tecnologica senza smarrire la propria umanità.

    Ottimizzare per l’AI non significa iniziare a scrivere come un robot, ma fare l’esatto contrario: scrivere in modo talmente umano, profondo e saggio da costringere persino la macchina più intelligente a fermarsi, ascoltare e dire: “Sì, questa è la risposta migliore”.


    Alcuni elementi da considerare

    Che cos’è l’ottimizzazione SEO per AI?
    È il lavoro di scrivere contenuti pensati non solo per il posizionamento classico, ma per essere compresi e citati dai sistemi di ricerca generativi. Non si parte più dalle parole chiave, ma dall’intenzione che si nasconde dietro la domanda dell’utente.

    Cosa cambiano AI Mode e AI Overview nella ricerca?
    Spostano la ricerca dalle stringhe di parole alle conversazioni complete. Le persone fanno domande articolate e ricevono risposte sintetizzate dall’AI, mentre lo spazio dei link blu tradizionali si riduce.

    La SEO è morta con l’intelligenza artificiale?
    No, cambia natura. Smette di essere una rincorsa tecnica alle classifiche e diventa la capacità di rispondere in modo chiaro, diretto e autorevole ai bisogni reali del pubblico.

    Come si scrive un contenuto che l’AI cita come fonte?
    Servono esperienza diretta, punto di vista originale e struttura ordinata. L’AI attinge da chi ha scritto prima, meglio e con più autorevolezza, e premia ciò che una macchina non può inventare dal nulla.

    Che differenza c’è tra SEO e GEO?
    La SEO punta a far comparire una pagina tra i risultati, la GEO punta a far comparire il contenuto dentro la risposta generata dall’AI. Sono complementari, non alternative.

  • I numeri che ci restituiscono la realtà di X, dopo tre anni

    I numeri che ci restituiscono la realtà di X, dopo tre anni

    Dopo oltre tre anni, il documento S-1 di SpaceX restituisce i numeri ufficiali di X. La pubblicità è a 1,8 miliardi nel 2025, contro i 4,51 di Twitter nel 2021. Gli utenti complessivi sono 550 milioni ma solo 4,4 milioni sono quelli abbonati.

    Da quando Elon Musk ha acquisito Twitter, poi trasformata in X, nell’ottobre del 2022 non si è più saputo nulla dei numeri ufficiali della piattaforma. Questo perché il proprietario di SpaceX, la società che presto sarà quotata in borsa e che ingloba tutte le realtà di Musk,la prima cosa che fece fu il delisting del titolo Twitter da Wall Street. Un’azione che determinò lo status dell’azienda a privata, rendendo difficile, se non impossibile, la diffusione di numeri ufficiali.

    Ma ora, strano davvero a dirsi, come anticipato prima, SpaceX sta per preparare la sua IPO sulla base di una realtà aziendale da 1,25 trilioni di dollari e fervono i preparativi, così come serve predisporre la documentazione sullo stato dell’arte di SpaceX.

    E uno dei documenti è il famoso S-1, il documento di registrazione fondamentale che le società devono depositare presso la SEC (Securities and Exchange Commission) prima di quotarsi su una borsa di Wall Street (come NYSE o NASDAQ), ci offre la possibilità, dopo oltre 3 anni, di accedere a dei dati ufficiali, finalmente.

    Diciamolo subito, i numeri che emergono raccontano una storia molto diversa da quella che il proprietario di X ha lasciato circolare in questi anni.

    Perché sono i razzi di SpaceX a svelare i conti di X

    Per capire come ci siamo arrivati, conviene seguire un percorso societario che ha dell’incredibile. In realtà l’ho accennato in apertura, ma vale pur sempre la pena ritornarci in maniera più chiara.

    Twitter diventa X dopo l’acquisizione di Musk e a marzo del 2025 viene assorbita dentro xAI, la società di intelligenza artificiale che sviluppa Grok. A febbraio del 2026 la stessa xAI viene acquisita da SpaceX, l’azienda dei razzi e dei satelliti Starlink.

    La piattaforma social che conoscevamo è così diventata la controllata di una controllata, inserita dentro un gruppo costruito attorno a missioni spaziali e modelli linguistici.

    Il paradosso è proprio questo, perché è grazie alla decisione di SpaceX di quotarsi in Borsa che i conti di X tornano alla luce.

    Il documento S-1 contiene tutto quello che X aveva smesso di dire dal 2022, dai ricavi alle perdite, dagli utenti ai rischi. La trasparenza, diciamolo chiaramente, non nasce da una scelta di apertura, ma arriva come effetto collaterale dell’ambizione di Musk di portare SpaceX davanti agli investitori.

    I numeri che ci restituiscono la realtà di X, dopo tre anni
    I numeri che ci restituiscono la realtà di X, dopo tre anni

    La pubblicità di X vale meno della metà di quando era Twitter

    Il dato che più interessa è anche quello che racconta meglio cosa è successo nel corso di questi anni.

    Nel 2021, ultimo anno pieno da società quotata, Twitter incassava 4,51 miliardi di dollari di pubblicità, secondo il modulo 10-K depositato all’epoca. Era il cuore del suo modello di business, la voce che teneva in piedi l’intera azienda.

    Poi è arrivato il boicottaggio degli inserzionisti, perché le scelte di Musk sulla moderazione dei contenuti, il ritorno di profili prima banditi e il declassamento del sistema delle spunte blu hanno spinto molti marchi a sospendere gli investimenti. La traiettoria, da lì, è stata una lunga discesa.

    Secondo i numeri diffusi, la pubblicità di X si è attestata a 1,8 miliardi di dollari nel 2025, in calo di circa 100 milioni rispetto all’anno precedente. Vale a dire appena il 39,9% di quello che valeva la pubblicità di Twitter prima dell’arrivo di Musk.

    Più della metà del fatturato pubblicitario si è dunque volatilizzata, e per capirlo basta un confronto semplice.

    Su ogni dieci euro che gli inserzionisti spendevano su Twitter nel 2021, oggi a X ne restano meno di quattro. Musk insiste, ed è giusto ricordarlo, sul fatto che nel 2025 quel dato è tornato a salire per la prima volta dall’acquisizione. Resta però una risalita minima, che lascia la piattaforma a meno della metà del punto di partenza.

    Il numero esatto, in realtà, non esiste

    Quel valore di 1,8 miliardi, per quanto possa sembrare solido, non compare nel documento S-1 come una riga di bilancio chiara e isolata. È una cifra che gli analisti hanno dovuto ricostruire, come ha mostrato l’analisi dettagliata di Digital Applied, leggendo le variazioni anno su anno e interpretando il modo in cui SpaceX ha scelto di raggruppare i propri ricavi.

    Il modulo depositato, infatti, non tratta più la pubblicità di X come una voce autonoma. Ma la annega dentro quello che chiama “segmento AI”, vale a dire un unico contenitore in cui finiscono insieme le entrate pubblicitarie della piattaforma, gli abbonamenti, i ricavi di Grok, la concessione in licenza dei dati e la vendita di capacità di calcolo per l’intelligenza artificiale. Tutto insieme.

    Il risultato è che lo stesso numero, per lo stesso anno, viene riportato da fonti diverse con valori che spesso si discostano. Ma il valore su cui converge la maggior parte delle letture è 1,8 miliardi di dollari.

    In teoria, un documento depositato presso l’autorità di vigilanza sui mercati dovrebbe mettere fine alle stime. In pratica, a documento depositato, circolano ancora tre cifre diverse per la stessa voce. E servono gli analisti a stabilire quale significhi cosa.

    Quando l’opacità è la scelta di chi possiede la piattaforma

    La vicenda si lega così a una dinamica che da tempo seguo su questo blog, quella che chiamo l’algoritmo del proprietario. È la pratica per cui le scelte di una piattaforma servono in primo luogo gli interessi di chi la possiede, e solo in secondo luogo quelli di chi la usa o la osserva da fuori.

    Di solito la applico al funzionamento degli algoritmi di raccomandazione, ma la stessa logica vale, identica, anche per i numeri.

    Togliere Twitter dalla Borsa, nel 2022, è stata la prima mossa di questa logica applicata alla trasparenza. Sottrarre i conti alla osservazione e all’analisi pubblica significa decidere da soli cosa il mondo può sapere di una piattaforma usata ogni giorno da centinaia di milioni di persone.

    E oggi, anche con un documento ufficiale sul tavolo, la pubblicità di X resta annegata in un segmento che mescola tutto. Così il dato più scomodo, quello sulla parte pubblicitaria pura, non è mai leggibile in maniera chiara.

    Gli abbonamenti che dovevano salvare tutto

    Quando comprò Twitter, una parte importante del piano di Musk consisteva nel ridurre il peso della pubblicità a favore degli abbonamenti. L’idea era trasformare gli utenti in clienti paganti, attraverso X Premium e i suoi vari livelli. I numeri del documento permettono finalmente di capire come è andata.

    X e Grok contano insieme circa 6,3 milioni di abbonati paganti. Di questi, all’incirca 4,4 milioni sono iscritti a X Premium e Premium+, mentre i restanti 1,9 milioni circa pagano per i vari livelli di SuperGrok.

    Sono i 4,4 milioni di abbonati a X, rapportati ai 550 milioni di utenti attivi della piattaforma, a raccontare quanto pesi oggi questo modello, perché restano sotto l’1% del totale.

    Significa che su cento persone che usano X meno di una paga per farlo. I ricavi da abbonamenti crescono, di 365 milioni di dollari nel 2025 secondo il documento, ma partono da una base ancora troppo piccola per colmare la voragine lasciata dalla pubblicità.

    Quanti sono davvero gli utenti di X

    Un altro dato merita attenzione, perché per anni è stato terreno di stime gonfiate. Il documento dichiara 550 milioni di utenti attivi mensili a marzo del 2026, una cifra più bassa di diverse stime circolate negli anni, comprese alcune dichiarazioni dello stesso Musk. Ancora più significativo è però il dato sui contenuti, perché gli utenti producono oggi circa 350 milioni di post al giorno, in calo rispetto ai 500 milioni che venivano dichiarati nel 2023.

    Meno utenti del previsto, meno contenuti prodotti e una pubblicità a meno della metà del suo valore storico. Eppure il documento racconta anche la parte in cui Musk continua a guardare avanti.

    SpaceX scrive di voler far crescere i ricavi di X aumentando il coinvolgimento degli utenti, spingendo la conversione verso gli abbonamenti a pagamento e allargando la base degli inserzionisti.

    La macchina di Grok che produce immagini a ritmo industriale

    C’è poi Grok, il modello di intelligenza artificiale che è ormai il vero motore di questa galassia societaria.

    Il documento rivela un dato che dà la misura di cosa significhi gestire un sistema del genere. Il generatore di immagini e video chiamato Imagine ha prodotto, nel primo trimestre del 2026, circa 10 miliardi di immagini e oltre 2 miliardi di video al mese.

    Sono volumi difficili persino da immaginare.

    Il documento stesso, nella sezione dedicata ai rischi, ammette che alcune modalità di Grok possono produrre contenuti più espliciti, deepfake non consensuali e materiale capace di esporre la società a contenziosi e all’attenzione delle autorità. Così la stessa macchina che dovrebbe sostenere il futuro economico di X è anche la fonte dei suoi rischi più seri.

    La pubblicità langue, gli abbonamenti crescono lentamente e il motore su cui si punta per il rilancio è proprio quello che genera le problematiche più gravi.

    Cosa ci dicono questi dati

    Quello che il documento S-1 ci consegna non è soltanto una fotografia dei conti di X dopo tre anni di buio. È la conferma di una cosa che possiamo finalmente dire con i numeri in mano.

    Rendere privata una piattaforma usata ogni giorno da centinaia di milioni di persone non obbliga a tenerne i conti al buio. Una società che esce dalla Borsa non ha più il dovere di pubblicare i propri dati, ma resta libera di farlo, e molte scelgono comunque la trasparenza.

    Musk ha scelto il contrario e per tre anni di X abbiamo saputo soltanto quello che il suo proprietario decideva di raccontare.

    E adesso che una finestra si apre, scopriamo che questa apertura è solo in parte.

    I conti di X tornano visibili per vendere SpaceX agli investitori, non perché qualcuno abbia deciso che il pubblico ha diritto di vederli.

    La pubblicità resta nascosta dentro un segmento che mette insieme tutto, gli utenti sono meno di quanto si diceva e il numero che più conta nessuno lo trova scritto nero su bianco.

    La vera domanda, semmai, riguarda il momento in cui SpaceX sarà quotata e X tornerà a far parte di una società pubblica. È lì che si capirà se quei conti diventeranno finalmente leggibili come dovrebbero, oppure se l’opacità avrà trovato il modo di sopravvivere anche dentro le regole della Borsa.

  • X riduce a 50 i post giornalieri per chi non paga

    X riduce a 50 i post giornalieri per chi non paga

    X ha tagliato il limite giornaliero di post per gli account senza abbonamento da 2.400 a 50, con un aggiornamento silenzioso della pagina di Help Center. Una riduzione del 98%, accompagnata da un nuovo tetto di 200 risposte al giorno e dall’invito implicito a passare a X Premium.

    X nei giorni scorsi ha tagliato il limite giornaliero di post per gli account senza abbonamento da 2.400 a 50, con un aggiornamento della pagina di Help Center.

    Si tratta di una riduzione del 98%, accompagnata da un nuovo tetto di 200 risposte al giorno e da una suddivisione in finestre semi-orarie. Non vi è stato alcun annuncio ufficiale, nessun post di Musk a fare da megafono.

    Ad accorgersene sono stati migliaia di utenti – compreso chi scrive – , ricevendo un messaggio che parlava di richieste automatizzate ogni volta che raggiungevano il nuovo limite. Una stretta che, nei modi e nei tempi, resta ancora davvero molto discutibile.

    Da una prima verifica, a ricevere questo messaggio sono stati anche utenti verificati, quindi utenti abbonati almeno a Premium.

    Il vecchio limite di 2.400 post al giorno, valido per tutti gli account verificati e non, era documentato sulla stessa pagina di Help Center ancora ad aprile. Oggi quel numero è stato sostituito da una soglia che è quaranta volte più bassa.

    X riduce a 50 i post giornalieri per chi non paga

    X e la stretta che cambia le regole del gioco

    Intendiamoci, 50 post al giorno significano in media due post all’ora, considerando le ore di veglia. Per la maggior parte degli utenti, quelli che postano due o tre volte al giorno, la differenza non si nota. E infatti la stessa X fa notare che l’80% degli account non posta praticamente mai. Per la grande massa silenziosa, il nuovo limite è invisibile.

    Ma il limite non è una soglia piatta che si raggiunge alla fine della giornata. È spezzato in finestre di mezz’ora, come specifica la stessa pagina di Help Center. In pratica, basta una raffica di risposte durante un evento dal vivo, una partita, una conferenza stampa, per consumare l’intera quota disponibile nell’arco di un’ora.

    E quando questo capita, il messaggio che si riceve non parla di abbonamento. Parla di automazione, di sospetto comportamento da bot, di richieste che il sistema considera anomale.

    In buona sostanza, la piattaforma sta dicendo agli utenti normali che il loro uso intenso, anche se perfettamente legittimo, viene trattato come traffico spam.

    Un cortocircuito comunicativo che ha generato confusione, perché molti utenti hanno pensato a un bug, a un’azione mirata contro il loro account, persino a una sanzione politica. Una confusione che ho vissuto, come dicevo prima, in prima persona.

    Domenica scorsa, 17 maggio, mentre seguivo la finale degli Internazionali di Roma vinta da Jannik Sinner, ho provato a postare un commento e mi sono ritrovato bloccato dallo stesso messaggio. Ma non ero il solo perché già nelle ore successive mi hanno scritto in tanti, preoccupati che X stesse restringendo l’uso della piattaforma a chi fa informazione.

    Non era una restrizione mirata. Era il nuovo limite che stava entrando in vigore proprio in quelle ore, mascherato da segnalazione antibot, senza alcun avviso che spiegasse cosa stesse davvero succedendo. Una stretta che resta, in ogni caso, molto discutibile nei modi e nei tempi.

    Il muro dell’abbonamento a X

    La motivazione ufficiale, quella che X mette in vetrina, parla di lotta allo spam, di tutela della stabilità tecnica, di pressione sui sistemi di infrastruttura. La pagina di Help Center parla di limiti pensati per «ridurre la pressione sui sistemi» e «minimizzare i tempi di inattività». Un linguaggio asettico, neutro, da manutenzione ordinaria.

    Ora in Italia il piano Basic di X Premium costa 3,54 euro al mese o circa 35 euro l’anno; il piano Premium completo arriva a circa 9,44 euro al mese o circa 99 euro l’anno; Premium+, dopo l’aumento di febbraio 2025 ha raggiunto i 44,85 euro euro al mese o poco meno di 445 euro l’anno.

    C’è un elemento che potrebbe aiutare a chiarire meglio la natura di questa scelta, ed è il modo in cui si lega a una distinzione che avevo già rilevato in un articolo precedente sull’algoritmo di X, quando il sistema di raccomandazione era stato riscritto con Grok e Phoenix.

    La piattaforma, in quel passaggio, aveva spostato il controllo dalle euristiche manuali a un modello di machine learning che apprende dai dati. Nessuna regola scritta che dicesse «penalizza i link esterni», ma l’effetto pratico era identico.

    Oggi succede qualcosa di simile, ma a un livello diverso. Non è più solo una questione di visibilità ridotta, è una questione di libertà di parola ridotta.

    L’abbonamento, in questa nuova geometria, non è più solo un servizio premium per chi vuole funzioni aggiuntive. Diventa una condizione strutturale per partecipare alla piattaforma con un volume normale di attività. Una cosa è offrire un’opzione a pagamento per ottenere di più, che poi nella realtà delle cose è impercettibile perché sottoposto all’algoritmo del proprietario. Un’altra è alzare un muro intorno all’uso base e chiedere un pagamento per scavalcarlo. La differenza, possiamo dirlo, è tutta lì.

    Cosa succedeva all’epoca di Twitter

    Per comprendere meglio quello che è successo, conviene tornare a com’era Twitter prima di Musk. Allora i limiti erano strumenti di gestione tecnica, non leve di tipo commerciale.

    Nei primi anni, il tetto era fissato a 1.000 “tweet” al giorno, valido per tutti gli account, verificati e non. Era una soglia che serviva a contenere il carico sui server e a scoraggiare gli abusi automatizzati.

    Poi, nel tempo, è stato alzato a 2.400 tweet (poi post) al giorno, sempre per tutti, sempre senza distinzione tra utenti paganti e non paganti.

    La verifica, allora, era un’altra cosa. Era gratuita, gestita dalla piattaforma, e serviva a certificare l’identità di personaggi pubblici, giornalisti, istituzioni. Non dava diritto a postare di più, non sbloccava nessun limite operativo, non concedeva alcuna corsia preferenziale. La spunta blu era un sigillo di autenticità, non un biglietto di accesso. La separazione tra utenti normali e utenti certificati era una questione di identità.

    Il cambio di paradigma è arrivato dopo l’acquisizione di Twitter da parte di Musk nell’ottobre 2022. Già nei primi mesi del 2023 alcuni utenti si trovavano bloccati per aver raggiunto il limite di 2.400 tweet al giorno, ma in molti casi senza nemmeno averli raggiunti, per via di problemi tecnici che colpivano una piattaforma con metà del personale licenziato.

    Pochi mesi dopo, a luglio 2023, è arrivata la stretta più clamorosa, con limiti di lettura, non di scrittura, differenziati tra account verificati e non verificati: un tetto di 10.000 post al giorno per i primi, 1.000 per i secondi, appena 500 per i nuovi account non verificati.

    Era la prima volta nella storia della piattaforma che un limite operativo veniva esplicitamente legato all’abbonamento. Prima, leggere e scrivere erano funzioni universali e gratuite.

    Da quel momento in poi, hanno iniziato a essere oggetto di tariffazione. E quello che oggi vediamo, con i 50 post originali e le 200 risposte al giorno, è la prosecuzione coerente di quella traiettoria. Solo che adesso non si tratta più di scoraggiare lo scraping. Si tratta di disegnare un’architettura in cui chi non paga viene compresso fino quasi a silenziarlo.

    Il messaggio antibot e l’ambiguità della comunicazione

    Quando un utente raggiunge il nuovo limite, il messaggio che riceve non chiarisce nulla. Non dice: «Hai superato il tuo limite di 50 post giornalieri, valutiamo insieme l’abbonamento». Dice invece: «Questa richiesta sembra essere automatizzata. Per proteggere i nostri utenti da spam e altre attività dannose, attualmente non possiamo completare questa attività. Riprova più tardi.»

    Comunica al normale utente che il suo comportamento è sospetto, e lo invita a riprovare più tardi. Senza spiegare che il «più tardi» non è una pausa tecnica, ma il riavvio di una finestra semi-oraria del nuovo limite.

    In teoria, dunque, X sta combattendo gli automatismi, ma in pratica sta trasformando ogni utente attivo in un automatismo presunto. La proporzione è quella di un sistema che, invece di profilare il bot e lasciare in pace l’utente reale, profila tutti come potenziali bot e poi offre l’abbonamento per dimostrare appunto di non essere un bot, in una logica rovesciata dove chi non paga diventa sospetto.

    La confusione generata da questo messaggio, un filtro antispam dichiarato ma che implicitamente è un muro a pagamento, è il motivo per cui in tanti hanno pensato a un bug, a una restrizione mirata, persino a un’azione contro i giornalisti.

    La realtà è più semplice e, per certi versi, più scomoda: il messaggio antibot copre una scelta commerciale. E quando la scelta commerciale viene mascherata da scelta tecnica, è lo stesso rapporto di fiducia con gli utenti a uscirne incrinato.

    L’algoritmo del proprietario e la libertà di parola a pagamento

    Resta da capire dove si colloca questa stretta nel disegno più ampio della piattaforma, e qui il quadro diventa chiaro. È il disegno che chiamo da tempo “l’algoritmo del proprietario”, quella pratica per cui le scelte tecniche di una piattaforma servono in primo luogo gli interessi strategici di chi la possiede, e solo in secondo luogo gli interessi della comunità che la usa.

    L’architettura, in questa logica, smette di essere uno spazio neutrale e diventa uno strumento di indirizzo verso il pensiero del proprietario.

    Avevo descritto questa dinamica analizzando il passaggio dell’algoritmo di X alla gestione tramite Grok, dove la penalizzazione dei link esterni passava dal codice esplicito al comportamento appreso dal modello, con la stessa logica del controllo ma in una forma più sofisticata e meno contestabile.

    Avevo poi ripreso lo stesso schema parlando delle modifiche annunciate da Nikita Bier, l’attuale responsabile prodotto di X, che lo scorso aprile aveva ridisegnato il sistema di incentivi per premiare il contenuto originale e ridurre la visibilità di chi pubblica con link esterni o reposta materiale altrui. E oggi torniamo lì, sullo stesso terreno, da un’angolazione diversa.

    Perché il limite sui post non è solo una questione di volume, è una questione di presenza del dibattito pubblico.

    Cinquanta post al giorno per chi fa informazione, per chi commenta in diretta, per chi gestisce account istituzionali, sono davvero pochi. E sono pochissimi se applicati a finestre semi-orarie.

    Una giornata di lavoro su un evento, una conferenza, una crisi politica, può consumare l’intera quota in mezza mattinata, e da quel momento in poi quel professionista esiste meno sulla piattaforma, esiste a singhiozzo, esiste poi solo se decide di pagare.

    Va detto, e questo precisato con onestà, che X non è l’unica piattaforma a praticare logiche di monetizzazione spinta. Meta sta seguendo strade analoghe, anche se per ora con muri a pagamento meno aggressivi. .

    Ma X, con questa stretta, è andato oltre. Infatti, ha trasformato la quota di parola in una tariffa. E lo ha fatto in maniera silenziosa, senza un comunicato, senza una spiegazione.

    Cosa significa davvero questo nuovo limite

    La categoria più colpita dalla stretta, lo si capisce subito, è quella dei professionisti dell’informazione, di chi usa X per informare condividendo notizie.

    L’effetto è un impatto diretto sulla libertà di espressione per quei giornalisti non Premium che usano X per fare cronaca dal vivo da un’aula di tribunale, da un’assemblea parlamentare, da una manifestazione. 50 post al giorno sono una soglia che non regge a una giornata di copertura intensa.

    Lo stesso vale per i divulgatori, per i ricercatori che usano X come strumento di lavoro, per i piccoli editori indipendenti che hanno scelto la piattaforma come canale principale di distribuzione.

    C’è poi una questione più ampia, che riguarda il pluralismo dell’informazione.

    Quando una piattaforma usata da centinaia di milioni di persone come spazio di discussione pubblica decide di legare il volume di parola al portafoglio, sta producendo un effetto che non è solo tecnico.

    C’è poi una questione che riguarda direttamente l’Europa. La Commissione UE ha già multato X per 120 milioni di euro lo scorso dicembre, prima sanzione della storia ai sensi del Digital Services Act. Una delle violazioni contestate riguardava proprio il sistema della spunta blu, considerato un design ingannevole perché lega un simbolo di affidabilità a un servizio a pagamento.

    Oggi, con la riduzione dei post per chi non paga, quel principio si estende ulteriormente. La spunta non è più solo una questione di credibilità apparente, è anche una questione di “volume di parola”. E questo, sul piano della trasparenza degli obblighi del DSA, potrebbe diventare un altro terreno di scontro tra Bruxelles e Musk.

    X e la trasformazione sempre più netta

    Quando Twitter è nato ormai 20 anni fa, nel 2006, l’idea era semplice . Era una piazza pubblica dove chiunque, con un account gratuito, poteva dire la sua nello stesso spazio in cui parlavano capi di Stato, premi Nobel, giornalisti, attivisti.

    L’unico vincolo erano i famosi 140 caratteri, poi diventati 280. Quel modello, nel bene e nel male, ha disegnato una stagione della comunicazione online. La stagione in cui la parola digitale era democratica by default.

    Quella stagione, oggi, possiamo dirlo, è finita. E su X tutto questo è ancora più evidente.

    Prima è stata la spunta blu trasformata in abbonamento; poi sono arrivati i limiti di lettura per chi non paga; poi le penalizzazioni per i link esterni, prima esplicite, poi implicite nel modello di Grok.

    Resta da vedere fino a che punto questa monetizzazione spinta potrà reggere prima di erodere il valore stesso della piattaforma, che dovrebbe essere quello dell’ascolto, del confronto, della relazione. Ormai tutti questi possiamo considerarli valori del passato. Vedremo cosa succederà.

  • Su Meta AI arrivano le chat in incognito con l’intelligenza artificiale

    Su Meta AI arrivano le chat in incognito con l’intelligenza artificiale

    Meta lancia Incognito Chat con Meta AI su WhatsApp e sull’app Meta AI. I messaggi non vengono salvati sui server, scompaiono alla chiusura della sessione e non possono essere letti né da Meta né da WhatsApp.

    L’annuncio è stato dato da Mark Zucherberg sulle sue piattaforme, presentando la nuova funzionalità come il primo importante prodotto di IA senza registro delle conversazioni e come tassello centrale della concetto, a lui molto caro, di superintelligenza personale.

    Non si tratta solo una nuova funzione di WhatsApp e dell’app Meta AI. Ma è il modo con cui Meta prova a rispondere a una delle obiezioni più frequenti che le persone fanno quando si parla di assistenti basati sull’intelligenza artificiale.

    E cioè: cosa succede a quello che racconto a questi sistemi? Chi può leggerlo? Per quanto tempo resta archiviato da qualche parte?

    La risposta arriva sotto forma di una nuova modalità di conversazione che Meta chiama “Incognito Chat” con Meta AI. Sarebbero quindi delle vere chat in incognito con la IA.

    Come detto in apertura, l’annuncio di oggi un tassello che si inserisce dentro la strategia della superintelligenza personale di Meta, quella visione di un assistente che ci conosce a fondo che si ricollega proprio a Muse Spark lanciato lo scorso aprile. E proprio in quel disegno questa novità trova il suo posto.

    Le chat in incognito con la IA e le parole di Zuckerberg

    «Oggi iniziamo a implementare Incognito Chat con Meta AI su WhatsApp e sull’app Meta AI: un modo completamente privato per interagire con l’IA, in modo simile a come la crittografia end-to-end impedisce a chiunque, persino a Meta o WhatsApp, di leggere le tue conversazioni. Questo è il primo importante prodotto di IA in cui non viene memorizzato alcun registro delle conversazioni sui server».

    Due i punti su cui soffermarsi in relazione alle parole di Zuckerberg.

    Il primo è il paragone diretto con la crittografia end-to-end, quella tecnologia che da anni protegge i messaggi tra persone su WhatsApp. Il secondo è la promessa che sui server di Meta non resta alcun registro delle conversazioni.

    Su Meta AI arrivano le chat in incognito con l'intelligenza artificiale

    È una dichiarazione netta, soprattutto se confrontata con quello che succede oggi con la maggior parte degli assistenti AI, dove le conversazioni restano archiviate per mesi e in molti casi vengono usate anche per migliorare i modelli.

    E Zuckerberg insiste proprio su questo confronto:

    «Le conversazioni sul tuo telefono scompaiono anche quando esci dalla sessione. Questo è diverso da altri prodotti di IA a scomparsa, in cui i registri delle conversazioni spesso rimangono sui server di altre aziende per molti mesi».

    La superintelligenza personale e lo spazio privato

    «Per ottenere il massimo dalla superintelligenza personale, avremo tutti bisogno di modi per discutere di argomenti sensibili in modo che nessun altro possa accedervi. Sono orgoglioso che MSL sia il primo laboratorio a fornire un’IA privata».

    La superintelligenza personale, nella visione che Zuckerberg ha pubblicato a luglio 2025 con il post Personal Superintelligence for Everyone, non è un sistema che automatizza il lavoro umano. È un compagno che ci conosce profondamente, comprende i nostri obiettivi e prova ad aiutarci a raggiungerli.

    Come avevo raccontato nell’articolo su Muse Spark, questa visione si appoggia su un vantaggio strutturale che nessun concorrente può replicare: 3,58 miliardi di utenti giornalieri sulle piattaforme Meta.

    Ma un assistente che ci conosce profondamente ha senso solo se può sentirsi raccontare cose che a chiunque altro non racconteremmo. Salute, soldi, lavoro, relazioni. E qui il problema diventa scomodo. Più l’assistente sa di noi, più diventa utile, ma anche più diventa rischioso che quei dati possano essere visti da qualcun altro.

    Incognito Chat- la modalità di chat in incognito con la IA – è la risposta di Meta a questo cortocircuito: uno spazio in cui parlare con l’IA, anche di temi sensibili, sapendo che la conversazione, una volta abbandonata, si chiude lì.

    Come funziona il Trusted Execution Environment

    «Incognito Chat gestisce tutte le inferenze dell’IA in un ambiente di esecuzione affidabile (Trusted Execution Environment) che garantisce che i tuoi messaggi non siano accessibili a noi».

    Proviamo a tradurlo in maniera semplice. Quando l’utente scrive un messaggio in modalità incognito, quel messaggio viaggia cifrato fino a un ambiente isolato dentro il cloud. Un ambiente che funziona dentro processori specializzati di AMD e NVIDIA progettati apposta per essere inaccessibili anche da chi gestisce i server.

    L’intelligenza artificiale elabora la richiesta dentro questa specie di stanza chiusa, genera la risposta, e poi tutto viene cancellato. Niente registri, niente copie di backup, niente accesso da parte di operatori umani.

    È la tecnologia che Meta chiama Private Processing, presentata per la prima volta a LlamaCon nell’aprile del 2025 e poi aggiornata a marzo del 2026. Su WhatsApp era già usata per funzioni più semplici, come i riassunti automatici delle conversazioni. Oggi alimenta una vera modalità privata di conversazione con l’assistente.

    Cosa si può fare e cosa no nella modalità di cha in incognito con la IA

    La funzione si attiverà su WhatsApp con una nuova icona dedicata nella chat uno a uno con Meta AI. E arriverà nei prossimi mesi anche sull’app standalone Meta AI, quella che si scarica separatamente. Quindi non riguarda solo WhatsApp, ma il rollout parte da lì.

    Ci sono però alcuni limiti pratici da conoscere. In modalità incognito si può solo scrivere e ricevere risposte di testo. Non si possono caricare immagini, non si possono generare immagini, non si possono fare conversazioni vocali.

    La sessione si chiude da sola anche bloccando il telefono o uscendo dall’app, e l’assistente perde il contesto di quello che è stato detto. Inoltre Meta chiede di confermare l’età, perché i minori di 13 anni non sono ammessi sulle sue piattaforme. E come nella modalità standard restano attivi i filtri di sicurezza che impediscono all’assistente di rispondere su temi pericolosi.

    Un rollout graduale e tutto da osservare in UE

    Sulla disponibilità è bene essere precisi. Meta dichiara apertamente che il rilascio è graduale e che la disponibilità varia in base all’account e alla regione geografica. Al lancio alcuni Paesi sono esclusi, come l’India.

    Per quanto riguarda l’Unione Europea, al momento non c’è una conferma esplicita di esclusione dal lancio iniziale, ma sappiamo bene che Meta procede sempre con maggiore cautela qui in UE, per via del quadro normativo del GDPR e del DSA. Resta da vedere in quali Paesi UE la funzione comparirà nelle WhatsApp degli utenti nelle prossime settimane.

    Da ricordare che la nuova funzionalità non si attiva tutta insieme per tutti, ma viene distribuita progressivamente. Anche dentro lo stesso Paese, alcune persone la vedranno prima di altre.

    I nuovi progetti attorno a Meta AI

    Incognito Chat arriva dentro una stagione di annunci di Meta sull’intelligenza artificiale che sta caratterizzando proprio queste settimane.

    A inizio aprile, come avevo raccontato nell’articolo su Muse Spark, Meta ha lanciato il primo modello sviluppato dal nuovo Meta Superintelligence Labs guidato da Alexandr Wang. Ed è proprio quel laboratorio, MSL, che Zuckerberg cita nel suo post come il primo a fornire un’IA privata.

    A questo si è aggiunto un altro fronte, quello dedicato ai più giovani. Lo scorso 23 aprile Meta ha annunciato nuovi strumenti per i genitori, che adesso possono vedere su Facebook, Messenger e Instagram i temi generali di cui i loro figli adolescenti hanno parlato con Meta AI nell’ultima settimana. La funzionalità è già attiva anche in Italia.

    E il 5 maggio Meta ha annunciato l’espansione delle protezioni Teen Account su Instagram nei 27 Paesi dell’Unione Europea e in Brasile, con un sistema di intelligenza artificiale che individua automaticamente gli utenti che potrebbero essere minorenni.

    Meta ha già anticipato che dopo Incognito Chat arriverà Side Chat con Meta AI, una funzione che permetterà di rivolgersi all’assistente direttamente all’interno delle conversazioni private con altre persone, senza che gli altri partecipanti vedano la richiesta. Anche questa basata sull’infrastruttura di Private Processing.

    Cosa resta da capire

    Alla fine possiamo dire che questa funzionalità di Incognito Chat Meta proverà a costruire le condizioni per la sua superintelligenza personale. Senza uno spazio davvero privato, l’assistente che ci conosce profondamente resta una promessa difficile da mantenere. E a queste condizioni, così come le abbiamo viste qui, la promessa prova a diventare prodotto.

    Staremo a vedere come si svilupperà nelle prossime settimane, come sempre.

  • X, l’inchiesta di Parigi diventa penale e nuova convocazione per Musk

    X, l’inchiesta di Parigi diventa penale e nuova convocazione per Musk

    La Procura di Parigi ha trasformato in indagine penale l’inchiesta su X. Musk e Yaccarino di nuovo convocati dopo la mancata comparizione del 20 aprile. Tra i nuovi sviluppi, la segnalazione a SEC e DOJ e il rifiuto di Washington a cooperare.

    L’inchiesta della Procura di Parigi su X, avviata lo scorso febbraio, ha cambiato natura. La notizia è che adesso il fascicolo sulla piattaforma di Elon Musk passa ufficialmente a indagine penale. E in aggiunta a questo, Musk e Linda Yaccarino, già ex CEO di X, sono nuovamente convocati a Parigi per rispondere personalmente alle accuse preliminari.

    La svolta arriva a poco più di due settimane dalla mancata comparizione di Musk e Yaccarino all’audizione libera del 20 aprile. Quell’audizione era stata fissata dopo la perquisizione della sede parigina di X del 3 febbraio scorso. I due erano stati citati rispettivamente come “gestore di fatto” e “gestore di diritto” della piattaforma.

    E nessuno dei due si è presentato.

    La nuova convocazione e cosa rischiano Musk e Yaccarino

    La Procura di Parigi ha tenuto a precisare, stavolta, che Musk e Yaccarino sono ora invitati a Parigi per rispondere a quelle che il sistema giudiziario francese chiama preliminary charges, cioè i capi d’imputazione preliminari. Si tratta del passaggio formale che apre la fase istruttoria vera e propria.

    Nel diritto penale francese, una volta notificate le accuse preliminari, il fascicolo passa nelle mani di un giudice istruttore. Da quel momento si apre un’indagine che può durare mesi o anche anni, e che può concludersi con il rinvio a giudizio o con l’archiviazione.

    Le accuse preliminari, in Francia, vengono normalmente notificate di persona. Ma la Procura ha precisato che, qualora Musk e Yaccarino dovessero mancare la convocazione anche questa volta, le accuse potranno essere formalizzate in loro assenza.

    In sostanza, la mancata comparizione non blocca l’iter, anzi lo accelera.

    I procuratori parigini, va precisato a scanso di equivoci, non hanno chiesto né l’arresto né il fermo dei due. La linea, almeno per ora, resta quella della convocazione. Ma il salto di livello è netto rispetto all’audizione libera del 20 aprile, che era ancora una richiesta di chiarimenti su base volontaria.

    TypeError: Cannot read properties of null (reading 'addEventListener')
    at https://www.franzrusso.it/wp-includes/js/dist/block-editor.min.js?ver=addf558a422e2ee57920:21:503394
    at https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:16501
    at B (https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:19822)
    at https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:20311
    at B (https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:19822)
    at https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:20311
    at B (https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:19822)
    at https://www.franzrusso.it/wp-includes/js/dist/compose.min.js?ver=7a9b375d8c19cf9d3d9b:9:20311
    at Vr (https://www.franzrusso.it/wp-includes/js/dist/vendor/react-dom.min.js?ver=18.3.1.1:10:73317)
    at Jr (https://www.franzrusso.it/wp-includes/js/dist/vendor/react-dom.min.js?ver=18.3.1.1:10:81304)

    X e i capi d’accusa che la Procura ha formalizzato

    Il quadro accusatorio ricalca, allargandolo, quello che era già stato delineato a febbraio. La Procura di Parigi indaga su una serie di reati che riguardano sia il funzionamento dell’algoritmo di X, sia i contenuti generati da Grok, l’intelligenza artificiale di xAI integrata nella piattaforma.

    Le contestazioni includono la complicità nella detenzione e diffusione di immagini pedopornografiche, la diffusione di immagini sessualmente esplicite non consensuali tramite deepfake, la negazione di crimini contro l’umanità, l’estrazione fraudolenta di dati e l’alterazione del funzionamento di un sistema di trattamento automatizzato in associazione a delinquere, e la gestione illegale di una piattaforma online.

    Avevo già riportato qui cosa successe a gennaio e il caso di Grok che generò migliaia di immagini di nudo e non solo, uno scandalo che ha pesato in modo decisivo nell’allargamento del fascicolo. Tra fine dicembre 2025 e inizio gennaio 2026, secondo l’analisi del Center for Countering Digital Hate, Grok aveva generato circa 3 milioni di immagini sessualmente esplicite di persone reali senza il loro consenso, di cui circa 23.000 raffiguranti minori.

    A questo si aggiunge il capitolo del negazionismo. In Francia, la negazione di crimini contro l’umanità è un reato. Grok, in più occasioni tra novembre 2025 e i primi mesi del 2026, ha generato in lingua francese contenuti che mettevano in dubbio l’uso delle camere a gas ad Auschwitz e che riproponevano cliché della propaganda negazionista.

    La segnalazione della Procura a SEC e DOJ

    A marzo 2026, la Procura di Parigi ha inviato una comunicazione formale al Dipartimento di Giustizia americano e alla Securities and Exchange Commission, l’autorità di vigilanza sui mercati finanziari statunitensi.

    Nella comunicazione, i procuratori francesi hanno suggerito che la controversia sui deepfake sessualizzati generati da Grok potrebbe essere stata “deliberatamente orchestrata per gonfiare artificialmente il valore di X e xAI, configurando potenziali reati“.

    Si tratta di un’ipotesi investigativa, non di un’accusa formale. Anche perché non si sa ancora di quale entità potrebbero essere le evidenze che la Procura francese ha raccolto in questo senso. Ma il fatto stesso che la Procura abbia ritenuto di doverne informare le autorità americane, e in particolare la SEC, sposta il piano della vicenda. Dalla sola moderazione dei contenuti si entra nel terreno della possibile manipolazione del mercato.

    Va detto, perché ha il suo peso, che X e xAI nel 2025 hanno completato la fusione e che SpaceX a inizio 2026 ha acquisito l’intero gruppo, dando vita a un colosso valutato 1,25 trilioni di dollari.

    Il rifiuto di cooperazione del Dipartimento di Giustizia americano

    La risposta di Washington alla richiesta francese, intanto, è arrivata in modo tutt’altro che ambiguo. Il Dipartimento di Giustizia americano, infatti, ad aprile, giusto un paio di giorni prima della prima convocazione di Musk a Parigi, ha respinto formalmente la richiesta di assistenza giudiziaria avanzata dalla Procura di Parigi.

    Nella lettera di rifiuto, di due pagine, il DOJ ha definito l’inchiesta francese come un “procedimento penale politicamente motivato volto a regolare in modo improprio, attraverso la prosecuzione, le attività commerciali di una piattaforma di social media“.

    Nel testo, riportato dal Wall Street Journal, si legge anche che le richieste francesi “costituiscono un tentativo di coinvolgere gli Stati Uniti in un procedimento penale” che, secondo l’amministrazione Trump, si porrebbe in contrasto con il Primo Emendamento della Costituzione americana sulla libertà di espressione.

    Il rifiuto di cooperare ha un effetto diretto e concreto. La Procura francese non potrà contare sull’assistenza delle autorità statunitensi per acquisire elementi di prova che si trovano sul territorio americano, e dovrà procedere con gli strumenti di cooperazione giudiziaria che restano a sua disposizione attraverso i canali europei.

    E c’è anche un effetto politico, che è ancora più visibile. Musk, nei rapporti con l’amministrazione Trump, dispone ormai di una copertura istituzionale netta e chiara.

    Il precedente Durov e la linea della Procura di Parigi

    La strategia della Procura di Parigi nei confronti dei vertici delle grandi piattaforme non nasce con il caso X. Si inserisce in una linea che la sezione cybercrime ha sviluppato negli ultimi anni e che ha già prodotto precedenti importanti.

    Come ricorderete, nell’agosto 2024 le stesse autorità francesi avevano fatto arrestare Pavel Durov, fondatore e amministratore delegato di Telegram, all’aeroporto di Le Bourget.

    A Durov erano state notificate accuse preliminari nell’ambito di un’indagine sulle responsabilità di Telegram per i reati commessi sulla piattaforma. Il fondatore di Telegram era stato poi rilasciato sotto cauzione, ma gli era stato vietato di lasciare la Francia per oltre sei mesi.

    Più di recente, nei primi mesi del 2026, la stessa Procura ha emesso mandati d’arresto contro i dirigenti di un sito video australiano oggetto di un’altra indagine sui contenuti.

    In sostanza, la Procura di Parigi sta perseguendo da tempo una strategia che mira a chiamare i vertici delle piattaforme a rispondere personalmente di quello che accade sui loro servizi. Il caso di Musk si inserisce in questo stesso solco.

    Il quadro europeo che si chiude attorno a X

    L’indagine francese si muove in parallelo a un quadro europeo che, nelle ultime settimane, si è ulteriormente irrigidito attorno a X e a Grok.

    Giusto pochi giorni fa, il giorno prima dell’annuncio della Procura di Parigi, il Consiglio dell’Unione Europea e il Parlamento europeo hanno raggiunto un accordo provvisorio per vietare i cosiddetti “nudifier tools”, gli strumenti di intelligenza artificiale utilizzati per generare immagini esplicite di persone senza il loro consenso.

    La decisione è arrivata in larga parte come risposta proprio alla controversia su Grok, e va a integrarsi con l’AI Act.

    A questo si aggiungono le indagini europee già aperte. Ricorderete come il 5 dicembre dello scorso anno la Commissione UE aveva inflitto a X la prima multa della storia ai sensi del Digital Services Act, pari a 120 milioni di euro.

    In aggiunta a questo, il 26 gennaio 2026 la Commissione aveva aperto un’indagine formale specificamente su Grok e sui deepfake sessuali.

    A questi due fronti, quello francese in sede penale e quello UE in sede regolatoria, si è poi aggiunta anche la sponda del Regno Unito, dove pure è in corso un’indagine sui contenuti generati da Grok.

    Cosa aspettarci dopo la convocazione

    La nuova convocazione di Musk e Yaccarino apre una fase in cui le incognite non riguardano più tanto il quando o il come. La domanda, in altre parole, non è più se la giustizia francese formalizzerà le accuse, ma in che tempi e con quali modalità lo farà.

    Resta da vedere se questa volta i due decideranno di presentarsi a Parigi. Le possibilità sono essenzialmente due.

    Da una parte, una scelta di comparizione che permetterebbe loro di esporre la propria posizione e di interloquire con il giudice istruttore prima delle decisioni sul rinvio a giudizio. Dall’altra, una nuova mancata comparizione che porterebbe alla notifica delle accuse in contumacia, con tutte le conseguenze del caso.

    La copertura politica offerta dall’amministrazione Trump al rifiuto di cooperare, unita alle dichiarazioni pubbliche con cui Musk ha più volte definito l’inchiesta francese una persecuzione, lascia intuire che la linea sia quella dello scontro più che quella del dialogo.

    Vedremo cosa succederà.